跳到正文

技術者経歴書

J.R.

全栈工程师 / AI・后端

自 2019 年起以 Python 为主线,从机器学习落地到生产级后端系统开发。现于日本从事基于 LLM 的遗留系统现代化相关开发。

向下滚动

ABOUT

自我介绍

我的优势在于对新事物强烈的好奇心和主动迎接挑战的态度。每当出现新的技术或工具,我都会先自己学习并亲手试用,因而上手很快,也能灵活适应新环境。我乐于接受变化,在享受新机会的同时持续成长。

学历

  • 河北经贸大学(本科)

    数学与应用数学

    2015.09 – 2019.06 ・ GPA 3.97 / 5,专业排名 9 / 30

  • SANKO 日本语学校 东京 ↗

    日语

    2024.07 – 2025.11 ・ 2024 年 7 月入学 / 2025 年 11 月退学・JLPT N2

个人信息

性别
男
年龄
30岁
国籍
中国
最近车站
龟有站
来日时间
2024.07
工作经验
约 6 年
所在地
东京

SKILLS

技术技能

Python 后端开发

使用 Django、Tornado、Flask 开发与维护 Web 应用;以 MySQL / MongoDB / Redis / Kafka / Milvus 进行数据处理与存储;基于 RESTful 与 Protobuf gRPC 的接口设计、实现与集成。

机器学习与计算机视觉

使用 scikit-learn 做回归、聚类等数据分析;使用 PyTorch 实现物体检测(Faster R-CNN)、识别(ResNet)及 YOLOv8;在 NVIDIA CUDA 与华为昇腾 ACL 上做推理加速及 C++ 调用。

前端开发

使用 Vue 2 / Vue-Element-Admin 搭建后台管理界面;使用 React、TypeScript、Angular 开发页面;用 ECharts 做数据可视化。

多语言开发

参与 C++11 项目;使用 Go 实现 API 与业务逻辑;有向 Rust 迁移的项目经验。

部署与运维

使用 Docker / docker-compose / Nginx / Shell 脚本进行构建与部署;在 AWS、Azure 上搭建并运维生产环境;使用 Fortify 等应对漏洞诊断。

数据处理与其他

基于 XPath 与 API 的爬虫开发;使用 NumPy、Pandas 做数据操作;使用 OpenCV 处理图片,用 FFmpeg 对视频做旋转、仿射、裁剪;在工作中应用 LLM / 提示词工程,曾搭建组内 GPT 机器人。

技术经验矩阵

◎:1 年以上实务经验 / ○:有实务经验 / △:了解

操作系统

  • Windows ◎
  • Windows Server ◎
  • Linux ◎
  • macOS ◎
  • AWS ◎
  • Azure ◎

语言

  • Python ◎
  • Vue.js ◎
  • React.js ◎
  • Angular.js ◎
  • TypeScript ◎
  • JavaScript ◎
  • HTML ◎
  • jQuery ◎
  • AJAX ◎
  • Go ◎
  • Shell Script ◎
  • C ○
  • C++ ○
  • VC++ ○
  • COBOL △
  • C# ○

数据库

  • MySQL ◎
  • PostgreSQL ◎
  • SQL Server ◎
  • SQLite ◎
  • MongoDB ◎
  • Redis ◎
  • Milvus ◎

Web / 应用服务器

  • Nginx ◎
  • Apache ◎
  • IIS ○
  • Tomcat ○

其他

  • Docker / docker-compose ◎
  • Kafka ◎
  • PyTorch ◎
  • scikit-learn ◎
  • OpenCV / FFmpeg ◎
  • gRPC / Protobuf ○
  • Ray ○
  • Selenium ◎
  • LLM / Prompt Engineering ◎
  • CUDA / Huawei Ascend ACL ○
  • Django / DRF ◎
  • Tornado ◎
  • Celery ○
  • Elasticsearch ○
  • Cython ◎
  • SWIG ○
  • TensorRT ◎
  • Suricata ○
  • ANTLR4 / Lark ◎
  • RAG / MCP ◎

技能总括

擅长领域
深度学习(CV 方向)机器学习数据分析网站开发爬虫
语言
Python(熟练)Vue / React / TypeScript(熟练)GoC++Rust(了解)
基础设施与中间件
MySQL / MongoDB / PostgreSQL / RedisKafka / MilvusDocker / docker-compose / NginxAWS / Azure

语言能力

  • 中文 母语

    母语

  • 日语 JLPT N2 / 简单业务会话

    在日语学校学习(2024 年 7 月至 2025 年 11 月)

  • 英语 技术文档读写

证书

  • 2026.07 日本语能力测试 JLPT N2

EXPERIENCE

工作经历

点击任意一家公司,查看在那里的职责、项目、系统数据流和收获。

  1. 2025.10 – 至今 1 年 1 个月

    ◯◯株式会社(SES)

    开发工程师(Python) ・ 受托开发 · 遗留系统现代化(SES)

    在日本以 SES 形式参与遗留系统现代化相关开发:用 ANTLR4 + RAG + MCP 自动生成 COBOL 功能说明书,为某大型电机厂商的部门系统开发人员与组织同步工具,并作为担当者设计 CMD → C# 的“规则 + 生成式 AI”自动转换系统。

    • Python
    • Lark
    • ANTLR4
    • Azure OpenAI
    • MCP
    • ChromaDB
    3 个项目
  2. 2023.07 – 2024.07 1 年 1 个月

    广州辰创科技发展有限公司

    Python 开发工程师 ・ 仿真推演(科研软件)

    在仿真推演产品线做后端与智能体开发:用 Go(Gin)实现战场仿真平台的业务主服务、引擎生命周期管理与多人协同编辑,并用 Python 对接 C++ 博弈平台,开发红蓝智能体与实时监控工具。

    • Go
    • Gin
    • Python
    • Tornado
    • MongoDB
    • MySQL
    2 个项目
  3. 2022.08 – 2023.07 1 年

    浙江木链科技有限公司

    Python 开发工程师 ・ 工控安防

    在工控安防方向做 Python 后端:参与旁路流量审计系统的流量处理链路、白名单检测引擎与 Django REST 接口,集成 Suricata 做黑名单检测,支持 27 种工控协议的深度解析。

    • Python
    • Django / DRF
    • Celery
    • Kafka
    • Redis
    • PostgreSQL
    1 个项目
  4. 2020.08 – 2022.08 2 年 1 个月

    人民中科智能技术有限公司

    算法应用工程师 ・ AI + 内容安全

    在内容安全中台负责算法调度与跨语言封装:用 Ray 编排 10+ 类算法能力,用 SWIG 把 C++ SDK 接入 Python,参与昇腾 Atlas 推理 SDK,并独立交付可离线部署的跨模态检索产品。

    • Python
    • C++11
    • Ray
    • Kafka
    • Protobuf
    • gRPC
    3 个项目
  5. 2019.07 – 2020.07 1 年 1 个月

    北京云上作科技有限公司

    软件开发工程师 ・ AI + 教育

    在 AI + 教育方向做算法落地与全栈开发:用 Mask R-CNN + ResNet 做课堂行为实时分析与预警,搭建内部数据标注与训练平台,并负责线上巡课统计后台、人脸核身与截图识别服务。

    • Python
    • PyTorch
    • Mask R-CNN
    • ResNet
    • YOLOv5
    • MXNet
    4 个项目

成长经历

  1. 01

    在校期间(数学专业):学习 Python-scikit-learn 数据分析与 NumPy / Pandas 数据操作;受当时人脸识别热潮影响,在学校计算机实验室学习了开源 C++ 人脸识别框架 SeetaFace。

  2. 02

    入职 AI + 教育后:在业务逻辑中基于 PyTorch 实现 Faster R-CNN 与 ResNet;Web 采用 Tornado,前端从 HTML/JS/CSS 转向 Vue,拓展了计算机知识。

  3. 03

    AI + 舆情时期:接触 CV、OCR、NLP 应用;在主线算法程序中用 Kafka 融合多平台业务,实践 Docker 与云上运维;学习模型蒸馏、剪枝,以及 CUDA / 昇腾的硬件层加速。

  4. 04

    安防行业:了解常见攻击手段与权限提升;熟练使用 Django;参与 C++ 向 Rust 迁移,以及 Python 提速的 Cython 化或改写为 Go。

  5. 05

    仿真推演软件时期:第一次用 Go 做服务端(Gin、WebSocket、goroutine),并用 Python 对接 C++ 推演平台、开发智能体。

  6. 06

    在日本:2024 年 7 月来日,在日语学校学习日语并取得 N2(2025 年 11 月退学)。此后以 SES 形式参与 COBOL 功能说明书自动生成(ANTLR4 + RAG + MCP)、人员组织自动同步工具,以及 CMD → C# 自动转换系统(规则 + 生成式 AI)的开发。

WORKS

项目经历

日本 2026.04 – 至今

遗留批处理(CMD/JCL)→ C# 自动转换系统

公共(自治体基干系统迁移) ・ 担当者(架构设计・核心开发・评审)

查看详情
  • Python
  • Lark (LALR)
  • regex
  • Azure OpenAI
  • C# / .NET
  • pytest
  • +1

将长期运行的 Windows 批处理脚本(CMD,Shift-JIS 编码)迁移为运行在自研批处理框架上的 C# 程序。人工逐本改写工时高、业务逻辑等价性难以保证,因此构建“规则转换 + 生成式 AI 补全”的两阶段自动转换系统,并以“宁可留 TODO,也不静默改变业务逻辑”为设计原则。

系统架构

两阶段转换架构
遗留 CMD 脚本Shift-JIS 批处理 阶段一 · 确定性转译流水线 预处理8 类归一化 LALR 解析Lark 490 行文法 AST 变换27 种节点 C# 生成类 / Main / using 规则引擎 + 变量展开33 内建命令 + 1,084 条映射 一次产物.cs (含 TODO) · .cs.ast · .utf8.cmd 阶段二 · AI 补全 CALL :LABEL 三方对齐TODO·AST·CMD 缓存查询SHA256 哈希 Azure OpenAItemperature 0 两层校验结构 + 业务语义 反馈式重试最多 7 次,仍失败留 TODO 最终产物.label.ai.cs(不覆盖原 .cs)

职责

  • 两阶段架构设计:阶段一用确定性规则完成大部分转换(预处理 → Lark 语法解析 → AST → 规则引擎 → C# 生成);阶段二仅对规则无法覆盖的 CALL :标签 子程序调用 LLM 生成 C# 方法,把 AI 的使用范围和风险压到最小
  • CMD 语法建模:编写并持续扩展约 490 行 Lark(LALR)文法,处理重定向符可出现在任意位置、< > & | 的二义性、%VAR:old=new% 置换、IF/ELSE 的多种括号写法、含日文的标签名等 cmd.exe 的怪癖
  • 输入归一化层(8 类预处理):在不改变语义的前提下统一混杂换行、行尾粘连括号、多行 ELSE、ECHO 元字符、全角空格等“脏数据”,让文法保持简洁
  • AST 与规则引擎:27 种自定义 AST 节点;33 个内建命令 + 1,084 条外部命令映射表(区分“作业进程”与“作业流”两种调用模式);变量展开区分字符串、参数行、整数表达式三种上下文
  • LLM 子程序转换与“语义保留”校验:LabelMapper 将 .cs 的 TODO、.cs.ast 的调用节点、.cmd 原文三方对齐;结构 + 业务语义两层校验(ERRORLEVEL、取消分支、错误跳转、状态标志必须保留);失败时带原因反馈重试最多 7 次,仍失败则保留 TODO 交人工
  • 成本与稳定性:以标签块归一化内容的 SHA256 为键做 JSON 缓存;429 / 5xx 指数退避;Chat Completions 不可用时自动降级到 Responses API;temperature=0 保证可复现
  • 质量闭环:约 465 个测试用例覆盖文法层与转译层;批量运行产出 .cs.ERR,按“CMD 原文问题 / 文法缺口 / 代码缺陷 / 环境”四类分类,并整理常见错误清单供团队复用

成果

  • ✓ 迁移过程中识别出多处遗留 CMD 的潜在缺陷(如缺少 & 导致 GOTO 实际不会执行、ECHO 输出 SQL 时 < 未转义),作为遗留系统问题记录在案
  • ✓ 示例:一本 117 行的数据联动作业 CMD 自动生成 156 行 C#,剩余 11 处 TODO 均为映射表未登记的外部命令,可通过补充映射表继续消减

数据流

遗留 CMD → 编码识别 → 输入归一化 → Lark 解析 → AST → 规则引擎 → C# 生成;TODO 子程序 → 三方对齐 → LLM 生成 → 两层校验(≤7 次重试)→ .label.ai.cs

参与阶段: 外部設計 / 機能設計 / 内部設計 / 製造 / 単体試験
  • Python
  • Lark (LALR)
  • regex
  • Azure OpenAI
  • C# / .NET
  • pytest
  • Git
所属:◯◯株式会社(SES) 进入公司页
日本 2026.01 – 2026.03(3 个月)

部门项目管理系统 · 人员组织自动同步工具

制造业(大型电机厂商) ・ Python 同步工具的开发、测试、上线与运维交接(派遣)

查看详情
  • Python
  • Selenium
  • paramiko
  • MySQL / MariaDB
  • Redmine REST API
  • SendGrid
  • +3

某大型电机厂商的软件技术部门以开源 Redmine 为底座,自建项目管理与状况报告平台(Angular + Go + Redmine)。人员与组织数据来自社内人员目录,而该目录没有可用的对外接口,因此我负责开发同步工具:用 Selenium 爬取成员与组织架构,自动同步为 Redmine 的账号、部 / 课组织与权限组,覆盖 4 个部、约 30 个课。

系统架构

同步工具的结构(我负责的部分)
① 客户内网 · WINDOWS 运用 PC ② AZURE VM · 本番服务器 任务计划程序 → executor.ps1 先运行 Excel 宏导出正式员工白名单 find_users_emails_and_departments 自动完成微软 SSO 登录 展开组织树,逐个部 / 课抓取邮箱 → new_users / new_organization.csv generate_all_users_data 按邮箱逐人检索:所属、职务、姓名 → all_users_data.csv transport_csv paramiko 按时间戳目录 SFTP 上传 remove_old_dir 清理过期 CSV 和日志 每步独立子进程,失败即中止后续步骤 社内人员目录 社内人员目录 (旧目录系统 已停用) 组织树 员工检索 SFTP cron → executor.sh 找到当天最新的数据目录 SFTP 接收目录 专用账号 · batchgroup 权限 manage_user_batch(11 个步骤) 1 csv_validator:表头、邮箱格式、危险字符 2 组织差分 → update_organization.sql 组织意外变更 → 退出码 2 → 中止并告警 3 人员差分 → update_users.sql 新成员开通 · 离开者停用 · 再入职解锁 4 权限组差分 → curl 脚本 状况报告组 · 部门内负责人组 · 白名单组保留 5 执行 SQL / 脚本 → 清理旧目录 两阶段执行 EXEC_UPDATE_USER_SQL_FLAG 控制是否直接写库 组织变更时先生成 SQL,担当者确认后 执行 executor_after_confirmed.sh MySQL(Redmine 库) users · email_addresses 部门 / 部 / 课 · 职务 · config Redmine REST API 组成员增删 SendGrid 3 类告警邮件 系统担当者 确认 SQL 后手动放行
在公司页查看另外 1 张架构图 →

职责

  • 数据源迁移:原人员目录停用后,将爬虫迁移到新站点,适配新页面结构与微软 SSO 登录,并兼容旧的职务标识,下游同步逻辑无需修改
  • 用 Selenium(Edge Headless)自动登录并遍历组织树,逐人检索所属与职务;通过 paramiko SFTP 将结果从内网 PC 单向推送到 Azure 服务器
  • 同步批处理:新旧数据差分,自动生成并执行 SQL,完成账号开通、停用、再入职解锁及部 / 课 / 职务同步;经 Redmine REST API 同步状况报告权限组,白名单成员不受影响
  • 用 SendGrid 实现 3 类异常告警;检测到意外的组织变更时自动中止,SQL 由担当者确认后再执行(两阶段),避免错误数据直接写入本番
  • 将分散在代码里的部门映射集中到数据库配置表;按客户方针对应 4 月组织变更,设计并执行覆盖页面、申请流程和权限组的测试用例
  • 定位并修复本番问题:重复人员导致的锁定误判、再入职账号缺失、网络波动导致的页面超时、Edge 驱动版本不匹配
  • 负责两套本番环境(内网运用 PC + Azure VM)上线:备份、部署、关闭写库试运行核对 SQL,再正式运行;编写运维手顺书(部署、告警说明、排错、组织变更 SOP)并完成交接
  • 用 Fortify / FOSSology 对全项目做安全与许可证扫描,修复 JSON 注入、SQL 注入等高危指摘,整理 OSS 许可证清单

数据流

社内人员目录 → Selenium 爬虫(内网 PC)→ CSV → SFTP → 差分 SQL / Redmine REST API(Azure VM)→ 账号・部课组织・权限组

参与阶段: 製造 / 単体試験 / 結合試験 / 運用保守
  • Python
  • Selenium
  • paramiko
  • MySQL / MariaDB
  • Redmine REST API
  • SendGrid
  • Bash
  • PowerShell
  • Azure VM
所属:◯◯株式会社(SES) 进入公司页
日本 2025.10 – 2025.12(3 个月)

基于 ANTLR4 + RAG + MCP 的 COBOL 功能说明书自动生成

AI(遗留资产的可视化・文档化) ・ 方案设计、实现、验证(个人主导)

查看详情
  • Python
  • ANTLR4
  • ChromaDB
  • SentenceTransformers
  • MCP (FastMCP)
  • Gemma-3 4B
  • +3

客户的核心批处理仍运行在几十年前编写的 COBOL 程序上:没有可用的设计文档,TR1-HINSHU 这类缩写变量的业务含义散落在数据库设计手册与术语表中,熟悉 COBOL 的人员也越来越少。目标是输入 COBOL 源码,自动输出业务人员也能读懂的日文功能说明书(Markdown)。设计原则:确定性的事情交给程序(语法、布局、调用关系),模型只负责“赋予含义并写成文字”。

系统架构

知识库 + MCP + 说明书生成流水线
① 离线 · 知识库构建(一次性) 资料 数据库设计手册 · 术语表 表 / 文件 / 作业流定义 语义切分 文件 → 记录 → 字段 → 组 统一为 {key, value} 只对 key(字段 ID)向量化 向量化 multilingual-e5-small 日 / 中 / 英检索 ChromaDB 别名:去除 OCCURS 下标 保留层级路径 MCP 服务器(FastMCP) lookup_field · lookup_record batch_lookup_fields · get_subroutine_summary 向量检索封装成工具 ② 在线 · 说明书生成(每个程序一次) COBOL 源码 Unisys 方言 预处理 Shift_JIS → UTF-8 去行号 · 方言指令 ANTLR4 解析 Cobol85.g4 → AST 调用图 + 拓扑排序 PERFORM · 过滤 EXT 段 自底向上 Gemma-3 4B 逐子程序生成 功能说明书 .md(日文) 按需检索变量定义 确定性的事交给程序(语法、布局、调用关系),模型只负责“赋予含义并写成文字”

职责

  • 模型能力验证与方向调整:对 Gemma-3 4B 做 COBOL 理解基准测试;在 Colab 上尝试 LoRA 微调但受显存所限无法完成。因业务词典随客户变化,转向无需重新训练的 RAG 方案
  • 知识库构建:把数据库设计手册、术语表、表 / 文件 / 作业流定义统一为 {key, value},按“文件 → 记录 → 字段 → 组字段”的层级做语义切分;仅对 key 向量化(multilingual-e5-small)存入 ChromaDB,并在检索前去除 OCCURS 下标、建立别名与层级路径
  • COBOL 解析:基于 Cobol85.g4 生成 Python 的 Lexer / Parser / Visitor;预处理 Shift_JIS → UTF-8、去除行号、处理 $SET 等方言指令;把解析树转成面向 LLM 的精简 AST;变量提取器支持 REDEFINES / OCCURS / COMP / 88 级
  • 调用层级分析:由 PERFORM 构建调用图,过滤 RTN / EXT 配对中只起出口作用的 EXT 段落,用拓扑排序确定自底向上的分析顺序
  • MCP 集成:用 FastMCP 把向量检索封装成 lookup_field / lookup_record / batch_lookup_fields / get_subroutine_summary 四个工具,模型只检索当前用到的变量,避免把几百个变量定义全部塞进上下文
  • 生成与提示词调优:逐个子程序抽取输入 / 输出 / 工作变量与被调用子程序,经 MCP 检索定义并带入下层摘要,由 Gemma-3 生成 Markdown;通过约束提示词去掉空项,并要求用业务语言描述而非直译 MOVE 语句

成果

  • ✓ 两本程序(13.7 KiB / 13.5 KiB)分别生成了约 6.5 KiB / 6.7 KiB 的说明书,检索出的术语与预期一致
  • ✓ 确立“静态解析 + RAG + 工具调用”的分层方案:按子程序拆分、自底向上分析,让 4B 小模型也能处理超出上下文的长程序,变量说明对应到正确的业务名称

数据流

知识库(手册 → 语义切分 → 向量化 → ChromaDB)⇄ MCP ⇄ COBOL 源码 → 预处理 → ANTLR4 → AST → PERFORM 调用图 → 拓扑排序 → Gemma-3 逐子程序生成 → 功能说明书 .md

参与阶段: 外部設計 / 機能設計 / 内部設計 / 製造 / 単体試験
  • Python
  • ANTLR4
  • ChromaDB
  • SentenceTransformers
  • MCP (FastMCP)
  • Gemma-3 4B
  • Hugging Face Transformers
  • Google Colab
  • WSL
所属:◯◯株式会社(SES) 进入公司页
中国 2023.07 – 2024.07(1 年)

战场平行仿真系统

仿真推演(面向科研单位) ・ 后端开发(Go / Python)

查看详情
  • Go
  • Gin
  • MongoDB
  • MySQL
  • Redis
  • NSQ
  • +5

公司核心产品,面向军工科研单位的 B/S 架构战场仿真平台。用户在三维数字地球上编排作战想定,一键下发到仿真引擎推演,实时回传态势进行三维展示、多人协同编辑、录制回放与效能评估。

系统架构

系统总体架构
L1 浏览器 想定编辑 Vue 2 + Cesium 三维数字地球 多人协同编辑 推演控制 启动 / 暂停 / 恢复 倍速 · 时间轴 态势展示 三维显示 · 录制回放 效能评估 L2 业务服务(Go) 业务主服务(Gin) 17 个模块 · 约 100 个接口 router / controller / service / model WebSocket Hub 按任务分房间 读写双协程 + 心跳保活 算子服务 想定 JSON → 引擎 XML(3000+ 行) GeoJSON 空间计算 · 态势录制 L3 推演控制 引擎生命周期管理 动态分配端口 · os/exec 拉起 goroutine 监听退出并回收 引擎控制台(Go) TCP 对接调度服务 · 透传命令 启停 / 暂停 / 恢复 HTTP 接口 雷达信号服务 Tornado + SciPy · Docker 线性调频脉冲 · 杂波 · 回波 L4 引擎与存储 仿真引擎(外部) 推演 · 实时回传态势 存储与消息 MongoDB · MySQL · Redis · NSQ

职责

  • 负责业务主服务(Gin + MongoDB)设计开发,按 router / controller / service / model 分层,完成型号、实体、装备、数据字典、模板、想定版本等 17 个模块约 100 个接口
  • 设计推演引擎生命周期管理:动态分配端口、想定导出为引擎输入、os/exec 拉起进程并登记,goroutine 监听退出自动回收资源,支持多场推演并行
  • 基于 WebSocket Hub 实现按任务分房间的想定多人协同编辑:读写双协程 + 心跳保活,想定树扁平化索引缓存,增量指令实时广播
  • 开发算子服务:想定 JSON → 外部仿真引擎 XML 转换(3000+ 行),GeoJSON 区域 / 交集 / 并集空间计算;实现态势按帧录制与暂停、倍速、时间轴回放
  • 用 Go 开发引擎控制台,通过 TCP 对接调度服务并透传引擎命令,提供推演启停 / 暂停 / 恢复的 HTTP 接口
  • 用 Tornado + SciPy 开发雷达信号生成服务(线性调频脉冲、杂波、回波),后台线程异步生成,Docker 部署

数据流

想定编辑(Vue + Cesium)⇄ WebSocket 协同 → Gin 主服务 → 算子服务(JSON → XML)→ 引擎控制台(TCP)→ 仿真引擎 → 态势回传 → 三维展示 / 录制回放

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Go
  • Gin
  • MongoDB
  • MySQL
  • Redis
  • NSQ
  • WebSocket
  • Python
  • Tornado
  • SciPy
  • Docker
所属:广州辰创科技 进入公司页
中国 2023.07 – 2024.07(8 个月)

智能博弈对抗推演

智能博弈(无人化空海对抗场景) ・ Python 开发 · 智能体与平台对接

查看详情
  • Python
  • ZeroMQ
  • Protobuf
  • MQTT
  • PyQt5
  • NumPy

无人化空海对抗场景(岛礁防御 vs 航母编队进攻)下的智能体指挥决策项目。C++ 博弈推演平台负责仿真裁决,Python 侧实现平台对接、红蓝双方智能体以及对抗过程的实时监控。

系统架构

对接层与智能体架构
L1 博弈平台(C++) 博弈推演平台 仿真裁决 · 毁伤判定 L2 对接层(Python) ZeroMQ(REQ + DEALER) 请求 / 响应通道 Protobuf 报文 推演数据的序列化 38 个封装接口 推演控制 · 单位 / 任务 / 毁伤查询 航线 · 起飞 · 编组 L3 推演主循环 Runner 固定步长驱动:观测 → 决策 → 指令 胜负计分 按轮次统计结果 L4 智能体 红方防御智能体 感知 → 信息融合 火力分配 → 打击校验 蓝方进攻智能体 多行动方案 无人机分队 · 饱和突击 参赛智能体评测 部署 16 个 · 定位依赖问题 拆解代表性策略 L5 监控 MQTT 外发 智能体态势 PyQt5 实时监控 多标签页:红蓝方单位与毁伤 离线落盘复盘 按轮次保存

职责

  • 基于 ZeroMQ(REQ + DEALER)与 Protobuf 实现平台对接层,封装推演控制、单位 / 任务 / 毁伤查询、航线、起飞、编组等 38 个接口;Runner 以固定步长驱动“观测 → 决策 → 指令”循环并完成胜负计分
  • 开发红方防御智能体:感知 — 信息融合 — 导弹 / 火炮 / 激光火力分配 — 打击校验的分阶段决策;开发蓝方进攻智能体:多行动方案、无人机分队起飞与饱和突击
  • 部署评测 16 个参赛智能体(规则 / 机器学习 / 深度网络),定位依赖与运行问题,拆解代表性策略并输出技术分享
  • 智能体态势经 MQTT 外发,用 PyQt5 开发实时监控工具,多标签页展示红蓝方单位与毁伤,支持按轮次离线落盘复盘

数据流

C++ 推演平台 ⇄ ZeroMQ + Protobuf ⇄ Runner(观测 → 决策 → 指令)→ 红 / 蓝智能体 → MQTT → PyQt5 实时监控

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • ZeroMQ
  • Protobuf
  • MQTT
  • PyQt5
  • NumPy
所属:广州辰创科技 进入公司页
中国 2022.08 – 2023.07

工控安全审计平台

工控安防(电力、制造) ・ Python 后端开发 ・ 团队 13人

查看详情
  • Python
  • Django / DRF
  • Celery
  • Kafka
  • Redis
  • PostgreSQL
  • +4

面向电力、制造等工控场景的旁路流量审计系统:探针抓取交换机镜像流量,经 Kafka 进入 Cython 协议解析引擎,按资产、白名单、黑名单三层策略检测并告警。支持 27 种工控协议深度解析(Modbus、S7COMM、IEC104、IEC61850 MMS/GOOSE/SV、DNP3、OPC UA/DA/AE、PROFINET、ENIP/CIP、BACnet 等),已在电力科研院所等项目中落地。

系统架构

总体架构与数据流
采集 · 探针 消息总线 解析 · 检测 存储 · 同步 应用 · 管理 离线告警 HTTP REST 规则 · 资产 · 协议开关 · 阈值 每 5s 拉取(热更新) 工控网络镜像流量交换机 SPAN 口 · 旁路只读 network-capturer 抓包探针 · Python Scapy L2 原始套接字 selector 多网卡轮询 Cython Cstat 计数 deque 缓冲 → Producer 运维保障 Supervisor 守护常驻进程 Celery 每 5 分钟巡检探针 抓包 / 写 Kafka 双计数 systemd 检查 Pilosa 状态 cpulimit 限制进程 CPU Suricata 4.0.4 AF_PACKET · cluster_flow 996 条工控漏洞特征规则 输出 unified2 二进制日志 Kafka 集群 cp-kafka 5.4 · ZooKeeper SASL 认证 · Docker 部署 retention.ms = -1 raw_packets 原始帧 · 保留 300GB alerts 检测告警 · 保留 1GB Kafka 设计要点 抓包与解析解耦、削峰 解析端重启不丢数据 Producer retries = 5 批量 100 条发送 BufferError → flush 重试 raw 300GB / 其它 1GB unified2 日志 /var/log/suricata packet-inspector 解析检测引擎 · Consumer 拉取 raw_packets · pypkt (Cython) 解析 70+ 协议 · 五元组+MAC+协议+载荷 → 哈希 · Redis 10s 过期窗口聚合计数 · 每 5s 批量 INSERT … RETURNING · WhitelistInspector 策略检测 · 异常 → Producer 写 alerts · ThreadPool(16) + fail2restart 自愈 详见 02 节内部线程图 store.py 告警入库 消费 alerts → sec_alert 表 Syslog 外发 · 推送演练靶场 Supervisor 常驻进程 gunicorn · celery worker/beat store.py · unified2_recorder db_2_pilosa · packet_stat detect_device_offline cpulimit unified2_recorder idstools 解析 → 黑名单告警入库 Redis 6 DB0/1 Celery broker/结果 DB2 流聚合窗口 TTL 10s DB3 设备活跃 TTL N 分钟 keyspace 过期事件 (Ex) PostgreSQL 10 packet_packet 流记录(含 count / length) sec_alert_secalert 安全告警 资产 · 白名单 · 黑名单 · 配置 wal_level = logical max_connections = 300 Kafka Connect · Debezium pgoutput 逻辑复制 → Avro auditor.public.* CDC 变更流 · Schema Registry db_2_pilosa AvroConsumer 写入位图 Pilosa 位图索引 流量统计 · 白名单自学习 Vue 2 前端 Vuex · Router · ECharts iView · axios · Electron Django 1.11 + DRF Gunicorn 8 workers :9003 资产 · 白名单 · 黑名单 安全告警 · 系统告警 数据包审计 · 报表导出 策略备份恢复 · 系统设置 用户 · 授权激活 白名单自学习 统一管理平台对接 drf-yasg 接口文档 约 12 个 Django app Celery worker + beat Redis 作 broker 报表 · 策略备份 · 统计 过期清理 · 进程巡检 bigdaddy 设备 Agent 改 IP / 时间 / 重启 配置抓包网卡 · 下发规则 固件升级 RSA + AES 证书生成 · 授权激活 对外对接 统一管理平台 · 国密 SM4 Syslog · 演练靶场推送 1 2 3 4 5 6 7 8 9 10
在公司页查看另外 2 张架构图 →

职责

  • 参与流量处理链路开发:抓包探针 → Kafka → 协议解析引擎 → PostgreSQL;利用 Redis 过期事件实现 10 秒窗口的流聚合与批量入库,显著降低数据库写入压力;利用 Redis TTL 实现设备离线检测
  • 实现基于五元组、MAC 和协议功能码的白名单检测引擎,用位图区分“行为异常”与“内容异常”;支持 IEC104 ASDU、OPC 接口 / 功能码的深度规则匹配,并支持按时间段自动学习生成白名单
  • 负责资产管理、白名单 / 黑名单策略、告警、报表等 Django REST 接口开发;用 Celery Beat 实现报表导出、策略备份、过期数据清理、探针健康巡检等定时任务
  • 集成 Suricata,解析 unified2 告警,接入近千条(996 条)工控漏洞特征规则实现黑名单检测
  • 基于 Kafka Connect(Debezium CDC)把数据同步到 Pilosa 位图索引,支撑流量统计与多维查询
  • (定制版)解析 IEC 61850 SCD 文件,自动生成变电站 IED 通信基线与拓扑

成果

  • ✓ 协议解析是 CPU 密集的字节级操作:解析库以 Cython 编写,把热点路径编译成 C 扩展,性能接近 C 且对上层保持 Python 接口;交付时只发布 .so,也起到保护核心代码的作用

数据流

交换机镜像口 → 探针(Scapy)→ Kafka raw_packets → Cython 协议解析引擎 → Redis 10s 流聚合 → PostgreSQL → 白名单检测 → alerts → Django + Vue;Suricata 并行做黑名单检测;PostgreSQL →(Debezium CDC)→ Pilosa

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • Django / DRF
  • Celery
  • Kafka
  • Redis
  • PostgreSQL
  • Pilosa
  • Suricata
  • Cython
  • Vue 2
所属:浙江木链科技 进入公司页
中国 2020.08 – 2022.08(2 年)

AI 内容安全算法中台

AI × 内容安全 ・ 中台・算法后端(Python / C++11) ・ 团队 15人

查看详情
  • Python
  • C++11
  • Ray
  • Kafka
  • Protobuf
  • gRPC
  • +12

对标大厂内容安全审核产品的 AI 系统,监控并解析公网媒体内容,为 G 端用户及友商提供审核能力。以订阅方式对外提供 10+ 类算法能力,覆盖图片、视频、音频、文本四种媒体类型。我负责其中的 Ray 调度中台与 SWIG 跨语言封装层,并参与昇腾 Atlas ACL 推理 SDK 与双平台模型工具链。

系统架构

五层技术栈全景
L5 交付层 产品交付 在线审核 SaaS · Kafka 回传 CDF 跨模态检索离线镜像 标准化开放 API · 签名/回调 L4 调度层 Ray 算法调度中台 Kafka 消费 Actor ×N MsgWorker 报文层 InferWorker 路由层 模型 Actor 池 ×8 L3 桥接层 SWIG 跨语言封装 .i 接口描述文件 _wrap.cxx → .so numpy 指针零拷贝 pyporn / pyivcpd … L2 推理层 C++ 推理 SDK acl_manager decoder · FFmpeg + DVPP inference / 前后处理 检索索引 L1 硬件层 异构算力 NVIDIA T4 · CUDA · TensorRT 7 INT8 华为昇腾 Atlas · ACL · DVPP 旁路 工具链 数据与模型工具链 爬虫采集 切帧 / 标注解析 pth → ONNX 鲁棒性评估
在公司页查看另外 4 张架构图 →

职责

  • 基于 Ray 构建分布式算法调度中台(主线负责):以 Actor 模型统一编排 10+ 类算法能力(成人内容识别、暴恐识别、OCR、台标、Logo、人脸检索、视频拷贝检测、跨模态检索等)
  • 消息可靠性:关闭 Kafka 自动提交,一批处理完再 commit(至少一次语义);puller Actor 数量由客户端动态探测分区数决定,与分区 1:1 对等启动
  • GPU 资源分片:以 num_gpus=0.2 小数资源声明,单卡并行承载 5 个模型实例(集群为单机 4 卡 Tesla T4)
  • 设计“报文层 — 路由层 — 模型层”三级抽象:报文层用 ray.wait 流式重组推理 batch,路由层按订阅的 algo_id 与模型能力集求交集动态分发;新增一类模型只需新增一个 Actor,不改动既有代码
  • 用 SWIG 4.0 把 C++ 算法库封装为 Python 扩展模块(主线负责):图像以 numpy 内存指针传入并校验 C_CONTIGUOUS,消除跨语言数据拷贝
  • 参与华为昇腾 Atlas ACL 推理 SDK(C++11 / CMake):设备与 Stream 管理,FFmpeg 解封装配合 DVPP 硬件解码;将向量检索由 AscendFaiss 迁移至 Milvus;适配 3 个 CANN 驱动大版本,并定位修复多芯片并行检索时 OpenMP 线程数不匹配导致的索引删除失败
  • 模型双平台落地:PyTorch → ONNX(opset 11)→ TensorRT 7 INT8(面向 Tesla T4)与昇腾 ATC .om 离线模型,同一业务代码支持 NVIDIA 与昇腾两套算力,累计维护 17 个模型包
  • 自研 OCR 敏感内容识别链路:PSENet 文本检测 + CRNN(LSTM) 识别 + 角度分类,识别结果经 DFA 算法与约 2 万条词库高效匹配

成果

  • ✓ 10+ 类算法能力在同一调度中台上线;GPU 版与昇腾版 SDK 归档合计 17 个模型包
  • ✓ 向量检索后端统一为 Milvus,GPU 与昇腾两条线的检索接口保持一致

数据流

Kafka 任务 → Puller ×N(与分区 1:1)→ 报文层 → 路由层(algo_id ∩ 模型能力)→ 模型 Actor 池(单卡 ×5)→ 结果 Kafka;C++ SDK 经 SWIG 接入;底库 → Milvus + MySQL

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験 / 運用保守
  • Python
  • C++11
  • Ray
  • Kafka
  • Protobuf
  • gRPC
  • SWIG
  • CMake
  • PyTorch
  • ONNX
  • TensorRT
  • 昇腾 ACL
  • Milvus
  • Redis
  • MySQL
  • MongoDB
  • Docker
  • FFmpeg
所属:人民中科 进入公司页
中国 2020.08 – 2022.08

跨模态检索离线产品(客户定制)

AI × 内容安全(客户定制离线交付) ・ 独立开发

查看详情
  • Python
  • Tornado
  • gRPC
  • Milvus
  • Redis
  • NumPy
  • +2

面向客户定制化需求的离线交付物:把面向开发者的多参数模型接口封装成一个简易检索接口,以 Docker 镜像交付;对外只暴露一个检索接口,屏蔽模型路径、特征维度、索引分区等全部内部参数。

系统架构

跨模态检索主流程与性能迭代
检索主流程 三模态输入 文本 / 图片 / 视频 base64 或明文 抽帧 / 解码 cv2 每 25 帧取一帧 仅视频分支 跨模态双塔模型 text.en / image.en 统一 512 维特征 视频特征合成 帧特征取均值 np.average Milvus gRPC 检索 TopK 候选 多条件逻辑引擎 与 / 或 / 非 / 包含 结果集合运算 RRF 重排序 倒数排名融合 1/(rank_l + rank_r) 批量打标签 QueryTags 批处理 TopK 标签词 Redis 缓存 → JSON 视频信息 / 标签二级缓存 Tornado 异步返回 性能优化四轮迭代 · 版本演进记录在 API/readme v1 · old gRPC 单条查询 基线实现 v2 gRPC 并发接口 批量请求合并 v3 · new 逻辑前置筛选 先筛选后打标签 v4 · thread 多线程分片查询 100 条/批 + np.dot 批量相似度

职责

  • Tornado 服务支持文本 / 图片 / 视频三模态输入:视频抽帧(每 25 帧取 1 帧),经跨模态双塔模型统一编码为 512 维特征,视频特征取帧均值
  • 经 gRPC 检索 Milvus 取 TopK 候选,用多条件逻辑引擎(与 / 或 / 非 / 包含)做集合运算,RRF 倒数排名融合重排,批量打标签,Redis 做二级缓存
  • 四轮性能迭代:gRPC 单条查询 → 并发批量接口 → 逻辑前置筛选 → 多线程分片查询(100 条 / 批)+ np.dot 批量矩阵点积;底库查询由 N 次串行 gRPC 收敛为 ⌈N/100⌉ 次并发批量查询
  • 同类离线产品另有视频特定物体过滤:抽帧 → SDK 提取 512 维特征 → gRPC 检索 Milvus → 后处理 → Docker 交付

成果

  • ✓ 累计交付 3 个客户定制离线版本(Docker 镜像)
  • ✓ 相似度计算由逐条比对改为单次矩阵点积,配合阈值截断提前退出

数据流

三模态输入(文本 / 图片 / 视频)→ 抽帧 → 跨模态编码(512 维)→ gRPC · Milvus → 逻辑引擎 → RRF 重排 → 打标签 → Redis 缓存 → JSON

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • Tornado
  • gRPC
  • Milvus
  • Redis
  • NumPy
  • OpenCV
  • Docker
所属:人民中科 进入公司页
中国 2020.08 – 2022.08

CV 数据处理系统

AI × 内容安全(数据基盘) ・ 系统工程师 ・ 团队 1人

查看详情
  • Python
  • Tornado
  • Vue
  • Vue-Element-Admin
  • MongoDB
  • OpenCV
  • +1

旨在将深度学习所需的数据处理工作可视化、简化,让部门成员通过 GUI 完成数据采集与加工。把分散的个人脚本系统化、集成化,提升复用性与效率。

系统架构

CV 数据处理系统的模块与数据流
L1 界面 Vue 管理界面 把每个人的零散脚本集成为统一界面 L2 接口 Tornado 接口层 RESTful 接口 · 任务下发 L3 三个模块 数据采集 RESTful 接入爬虫 API 服务 界面下达采集任务 数据处理 OpenCV 图像脚本 · FFmpeg 视频脚本 文件上传断点续传 模型缺陷分析 初打标签 + 人工确认(界面化) 导入数据集与模型路径 L4 产出 MongoDB 采集结果 处理后的图片 / 视频 裁剪 · 变换等 PR 指标 + PDF 报告 后端自动生成

职责

  • 数据采集模块:以 RESTful API 接入爬虫服务,从界面下发采集任务,结果存入 MongoDB
  • 数据处理模块:将 OpenCV 图像处理、FFmpeg 视频处理封装为 Tornado 接口,通过 Vue 界面操作;设计分片断点续传上传
  • 模型缺陷分析模块:将初打标与人工确认界面化;输入多数据集/模型计算 PR 指标并自动生成 PDF 报告
  • 前后端均参与,包含页面代码修正与 UI 改善
参与阶段: 要件定義 / 外部設計 / 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • Tornado
  • Vue
  • Vue-Element-Admin
  • MongoDB
  • OpenCV
  • FFmpeg
所属:人民中科 进入公司页
中国 2019 – 2020

AI 课堂行为分析系统

AI + 教育 ・ 全栈工程师(算法 · 后端 · 内部训练平台) ・ 团队 5人

查看详情
  • Python
  • Tornado
  • PyTorch
  • maskrcnn-benchmark
  • face_recognition (dlib)
  • OpenCV
  • +6

用教室摄像头识别学生的上课行为(抬头、低头、举手、趴桌、扭头等),通过人脸识别对应到具体学生,再提供实时预警和多层级的课堂报表。我开发了两个子系统:面向学校的实时分析与预警平台,以及内部使用的数据标注与模型训练平台。

系统架构

实时分析与预警平台总体架构
采集层 流媒体 & 推理层 数据层 服务层 客户端 教室摄像头 RTSP 视频流 演示视频流 infinitevideo.sh FFmpeg 循环推流 直播链路(ClassDetailHandler 打开课堂详情时启动) FFmpeg RTSP→RTMP 转推 nginx-rtmp rtmp://…/mytv/ H5 播放器 ckplayer/video.js 启动 / 停止分析进程(nohup + kill,先查剩余显存) GPU 推理进程 · 每个班级一个 · front_back_frame ①OpenCV 读流 + 丢帧控制 视频时间戳落后于实际时间就跳帧,保证实时 ②Mask R-CNN(R-101-FPN)检测学生 只保留“人”,置信度 ≥ 0.7,重叠框去重(0.8) ③ResNet18 行为分类(6 类) 单人图补成正方形 → 224×224;置信度 < 0.95 记为“不确定” ④face_recognition 识别学生身份 CNN 定位人脸 → 128 维特征 → 与班级人脸库比对 ⑤跨帧跟踪 + 轨迹内身份投票 5 秒窗口双向重叠率关联;轨迹内取出现最多的学生 ID 趴桌 / 扭头 → 裁出头像,base64 写入告警 写入 MongoDB realtimewarning 每班最新一帧结果 record_pics 逐帧历史记录 pg_classes 班级·视频流·人脸库·进程 school/class/student 学校、班级、学生档案 students_performances 每节课的行为表现 bf_kaoqin … 客户考勤等定制数据 Tornado Web :8080 · pymongo 账户系统 安全Cookie·三种角色 预警系统 轮询 /getfaster 报表视图 学生/课堂/年级/学校 客户定制页 客户 A · 客户 B 小程序 API xcx.py 第三方平台开放 API jyd_api.py Amaze UI · ECharts 校长 / 老师 浏览器 微信小程序 家长 / 老师 第三方平台 第三方系统 运维与交付 supervisor 守护 4 个进程(Web · 分析 · 推流 · VPN) | Cython 把核心算法编译成 .so | 加密狗授权 | Linux + NVIDIA GPU(CUDA)
在公司页查看另外 2 张架构图 →

职责

  • 两阶段识别:Mask R-CNN(R-101-FPN)检测学生 → ResNet18 做行为分类(6 类,置信度低于 0.95 记为“不确定”);比让检测模型直接分类更准,且行为类别调整时只需重训小的分类器
  • 实时分析:OpenCV 读 RTSP 流,视频时间戳落后于实际时间就丢帧以保证实时;每个班级一个独立 GPU 进程,启动前用 nvidia-smi 检查剩余显存
  • 跨帧跟踪与身份识别:自研 5 秒窗口的双向重叠率跟踪;face_recognition(dlib)提取 128 维特征与班级人脸库比对,同一轨迹内取出现最多的学生 ID 投票,低头、侧脸时身份仍能认对
  • 趴桌 / 扭头实时告警:裁出学生头像(base64)写入告警;最新结果与逐帧历史分开存入 MongoDB
  • Tornado 后端:账户与三种角色、预警与报表(学生・课堂・年级・学校四个层级)、微信小程序 API 与第三方平台开放 API;对接产品经理的原型并设计接口协议字段
  • 用 scikit-learn 分析行为数据,输出每位学生的周报、月报与学期报告,推送到家长的微信小程序
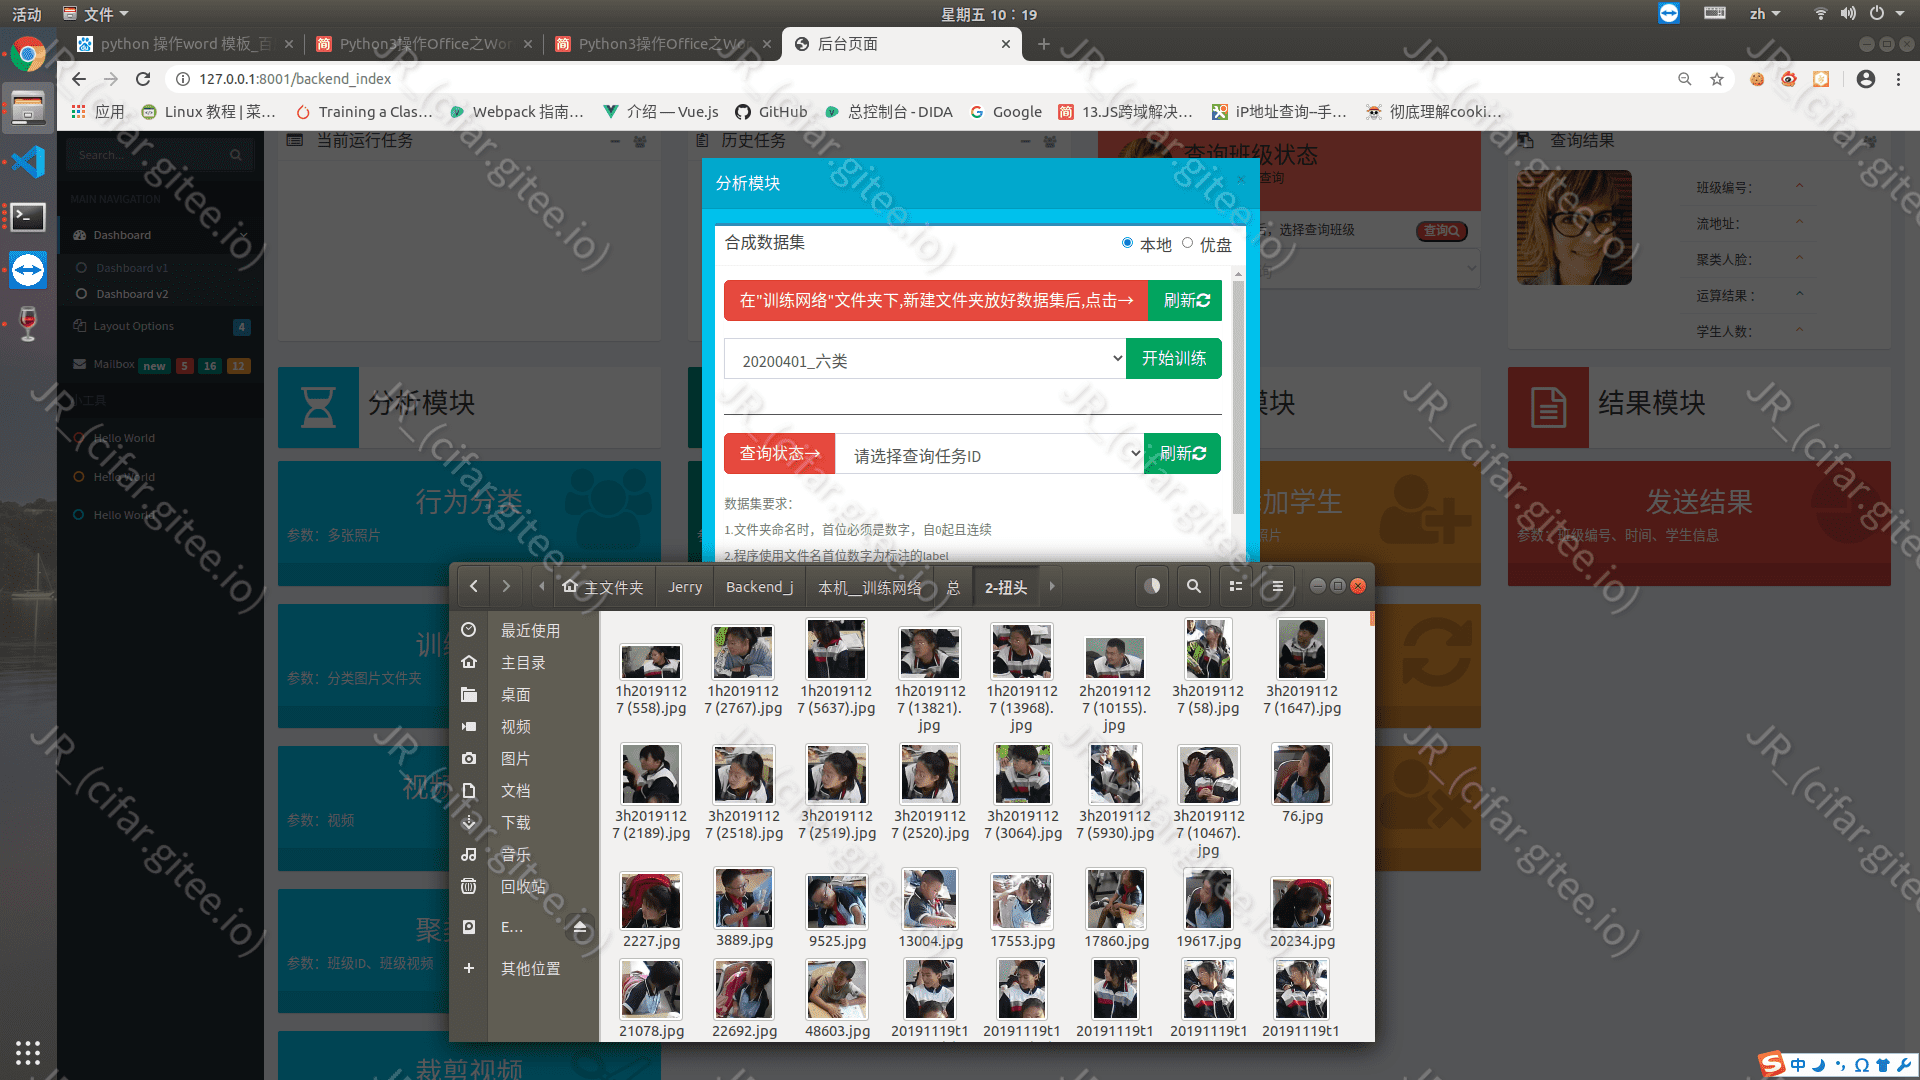
  • 内部数据标注与训练平台:视频剪辑 → Mask R-CNN 预标注(生成 labelme JSON)→ 人工修正 → 裁图 → 建数据集 → ResNet18 训练(断点续训、loss / 准确率曲线)→ 验证;整节课离线分析模块即实时算法的原型
  • 交付:核心跟踪算法用 Cython 编译为 .so,配合 supervisor 守护与加密狗授权,在多个客户处私有化部署

成果

  • ✓ 同一套代码同时服务 3 个客户的定制接口、完整的第三方开放 API 与微信小程序
  • ✓ 把数据生产做成网页工具,用模型预标注减少人工量,非算法人员也能参与标注

数据流

摄像头 RTSP → OpenCV 读流 / 丢帧 → Mask R-CNN 检测 → ResNet18 行为分类 → 人脸识别 + 跟踪 / 投票 → MongoDB → Tornado 页面 / 实时告警 / 微信小程序

参与阶段: 外部設計 / 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • Tornado
  • PyTorch
  • maskrcnn-benchmark
  • face_recognition (dlib)
  • OpenCV
  • FFmpeg
  • MongoDB
  • scikit-learn
  • Cython
  • ECharts
  • jQuery
所属:北京云上作科技 进入公司页
中国 2020

AI 诊断性巡课系统

AI + 教育(线上课堂) ・ 统计引擎后端、管理后台前端、参与算法分析

查看详情
  • Python
  • Tornado
  • Elasticsearch
  • Redis
  • Vue 2
  • Element UI
  • +4

在线英语课场景(疫情的原因改为线上课程)下实时采集师生音视频,经 ASR / CV / VAD 结构化后:对红线行为(说中文、老师说话过久、学生参与过少、离开镜头、黑屏或掉线)做准实时告警;并输出教质指标报表,按总部 / 分公司 / 校区、课程、教师、学生多维度对比排名。

系统架构

数据采集到告警展示的链路
采集端 接入 · 存储 · 事件 结构化算法(gRPC) 检索 · 分析 · 展示 浏览器 <video> web-video-capture.js 每秒 1 帧 · 音频每 10 秒一段 上行约 30kbps · 开销 <5% IOAuthProxy 授权服务 :9001 Aliyun OSS 公有云 MinIO 私有化部署 Notification Hub OSS 触发器 → MNS ASR Worker中英文语音转文字 CV Worker人脸位置/朝向/表情 Sound (VAD)发声起止和时长 Elasticsearch当时序库用 Analyse TaskQueue Analyse Enginestats_engine :9002 ReportDB+ ClassDB 排课 管理 后台 Vue MQTT 事件队列 1883 / 8083 / 8084 申请 Token webpwebm 红线事件 WebSocket 推送 → 老师页面告警

职责

  • 统计引擎后端(Tornado,约 1650 行、21 个路由):课堂 / 教师 / 学生的列表、详情与历史趋势,教学态度时序曲线,样板课堂 TopN
  • Elasticsearch 查询:bool + terms + range 组合,terms 聚合下嵌套 avg 子聚合(按课堂算教师平均 happy 概率、词数、语速),大结果集用 scan / scroll 遍历;CV 与 ASR 多源结果在应用层合并后排序
  • 管理后台前端(vue-element-admin 4.4):基于角色的动态路由权限、数据大屏、课堂 / 教师 / 学生列表与详情、排名、趋势、筛选;ECharts 可视化,Docker 化与多环境配置
  • 参与算法分析:综合学员说话比例、连贯表达与情绪正向程度,找出约 30 秒的“高光时刻”片段,并标记噪音、课件语音干扰、家长陪同等异常,用于给家长的学员表现报告

数据流

页面采集 SDK → OSS → ASR / CV / VAD Worker → Elasticsearch → 分析 / 统计引擎 → 管理后台 + MQTT 实时告警

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • Tornado
  • Elasticsearch
  • Redis
  • Vue 2
  • Element UI
  • ECharts
  • MQTT
  • Docker
  • Alibaba Cloud
所属:北京云上作科技 进入公司页
中国 2020

FaceID 人脸核身与人脸检索

AI + 教育(人脸核身) ・ 算法与服务开发

查看详情
  • Python
  • PyTorch
  • MXNet
  • dlib
  • ResNet18
  • Redis
  • +3

为在线教育客户做的人脸核身:从上课视频中确认出镜学员是否为本人,并支持全库 / 增量 / 指定人的人脸检索,用来发现“一人多号”或“多人共号”。

系统架构

核身与检索的推理流程(v3)
视频 上课视频文件 随机抽帧 缩放到 320×240 人脸检测 YuFaceDetectNet · PyTorch 5 点关键点 仿射对齐 逐张人脸 质量过滤(MXNet Gluon · CPU) 遮挡 眼 / 鼻 / 嘴 > 0.5 则跳过 姿态 / 模糊 偏航 · 俯仰 · 翻滚 · 模糊度超限则跳过 年龄 取最小年龄(< 17 岁)锁定学员 ResNet18 特征 PyTorch · 余弦相似度 比对与存储 首次:录入特征 存入 Redis hash 之后:核身 / 检索 全局 · 增量 · 指定人 授权控制 + Cython 交付 AES 额度 · SETNX 锁 · .so

职责

  • 推理流程:随机抽帧 → YuFaceDetectNet 检测 + 5 点关键点 → 仿射对齐 → 遮挡 / 姿态模糊 / 年龄三个模型过滤 → ResNet18 提取特征并做余弦相似度比对;取年龄最小的人脸(< 17 岁)锁定学员本人、排除家长
  • 多框架混合推理:检测与特征提取用 PyTorch,遮挡、姿态、年龄用 MXNet Gluon,统一跑在 CPU 上;从 v1.0 到 v3.4 持续迭代(dlib 68 点 + Laplacian 模糊检测 → 更换模型与对齐 → 加入三个质量模型 → 重写全库检索与视频校验)
  • 用 Redis 存放特征,支持全局、增量、指定人三种检索;全库两两比对按代码注释估算约 4000 万次
  • 商业授权控制:调用次数、到期时间、每日额度经 AES 加密存入 Redis,SETNX 做分布式锁,校验设备 SN;核心模块用 Cython 编译为 .so 交付
  • 配置按“命令行参数 > 环境变量 > JSON / YAML”的优先级读取;Docker 部署,构建时从 OSS 拉取模型权重

数据流

视频 → 随机抽帧 → 人脸检测 / 对齐 → 遮挡·姿态·年龄过滤 → 特征提取 → 余弦比对 / Redis 特征库 → 核身 / 检索结果

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • PyTorch
  • MXNet
  • dlib
  • ResNet18
  • Redis
  • Cython
  • Docker
  • OSS
所属:北京云上作科技 进入公司页
中国 2020

微信截图智能识别(朋友圈广告投放核查)

AI + 营销核查 ・ 训练、推理、服务与部署

查看详情
  • Python
  • PyTorch
  • YOLOv5
  • PaddleOCR
  • PaddlePaddle
  • Tornado
  • +3

对上传的微信截图做自动识别,用于核查朋友圈广告投放:判定截图类型(会话 / 朋友圈列表 / 朋友圈详情),提取发布时间、广告文案、海报 ID、二维码链接以及点赞与评论数。

系统架构

截图识别流程
截图上传Tornado POST 校验 + 存 OSStoken · MD5 · nanoid YOLOv5s 主检测7 类图标 / 二维码 规则分类按目标和相对位置 会话消息 · 有加号或三点图标 朋友圈列表 · 有相机图标 → 检测分组可见 其他 朋友圈详情 · 二维码在详情页的相对位置 PaddleOCR(DB 检测 + CRNN 识别) 按位置取发布时间 · 按和二维码的相对位置取文案 按"ID"关键词取海报 ID 二维码解码 检测框裁剪 → 解出 URL 点赞数 / 评论数 裁剪右下角 → YOLOv5 找图标 → 3 层 CNN 识别数字(验证集 98.25%) 汇总 JSON 返回 · 全量结果和耗时写入 Elasticsearch · 自定义错误码(212 / 218 …)

职责

  • YOLOv5s 主检测(7 类界面元素)并用规则判定截图类型;自行标注 1 万多张截图与 1 千多张点赞 / 评论图标,k-means 聚类先验框
  • 朋友圈详情:PaddleOCR(PP-OCR,DB 检测 + CRNN 识别)按版面位置取发布时间、广告文案与海报 ID;二维码解码;右下角裁剪后用 YOLOv5 检测点赞 / 评论图标,再用 3 层 CNN 识别数字
  • Tornado + PyTorch + PaddlePaddle 服务:token 与 MD5 完整性校验,nanoid 请求追踪,原图存 OSS,全量结果与耗时写入 Elasticsearch,用于排查线上异常返回
  • 升级 PP-OCR 模型版本,提高海报 ID 与发布时间的识别率

成果

  • ✓ 数字识别的 3 层 CNN:训练集 98.95% / 验证集 98.25% / 测试集 84.45%

数据流

截图上传 → token / MD5 校验 → YOLOv5 控件检测与分类 → PaddleOCR + 二维码 + 点赞数识别 → JSON 返回;全量结果写 Elasticsearch

参与阶段: 機能設計 / 内部設計 / 製造 / 単体試験 / 結合試験
  • Python
  • PyTorch
  • YOLOv5
  • PaddleOCR
  • PaddlePaddle
  • Tornado
  • Elasticsearch
  • OSS
  • Docker
所属:北京云上作科技 进入公司页

其他项目

  • 直播流审核盒子
  • 风格画生成(类 Midjourney)
  • 车辆行为分析
  • 人脸先天性疾病识别
更多项目(Github 托管页) ↗

ARCHIVE

早期作品 — 2019

大学到工作第一年(2019 年前后)个人做的东西——从数学专业自学进入 ML 和 Web 的阶段记录。完整版原样保留在 /2020/。

2018.10 – 2019.01

音乐类专业统考 · 考务与评分系统

覆盖现场抽签、检录、评分到成绩统计的全流程,在考点局域网内运行。用 Win32 Raw Input 区分多块 USB 小键盘,让每位评委独立打分;ActiveX 控件嵌入 Web 页面,实现分差超限预警与去最高最低取平均。
  • C#
  • ASP.NET MVC 5
  • SQL Server
  • Redis
  • ActiveX
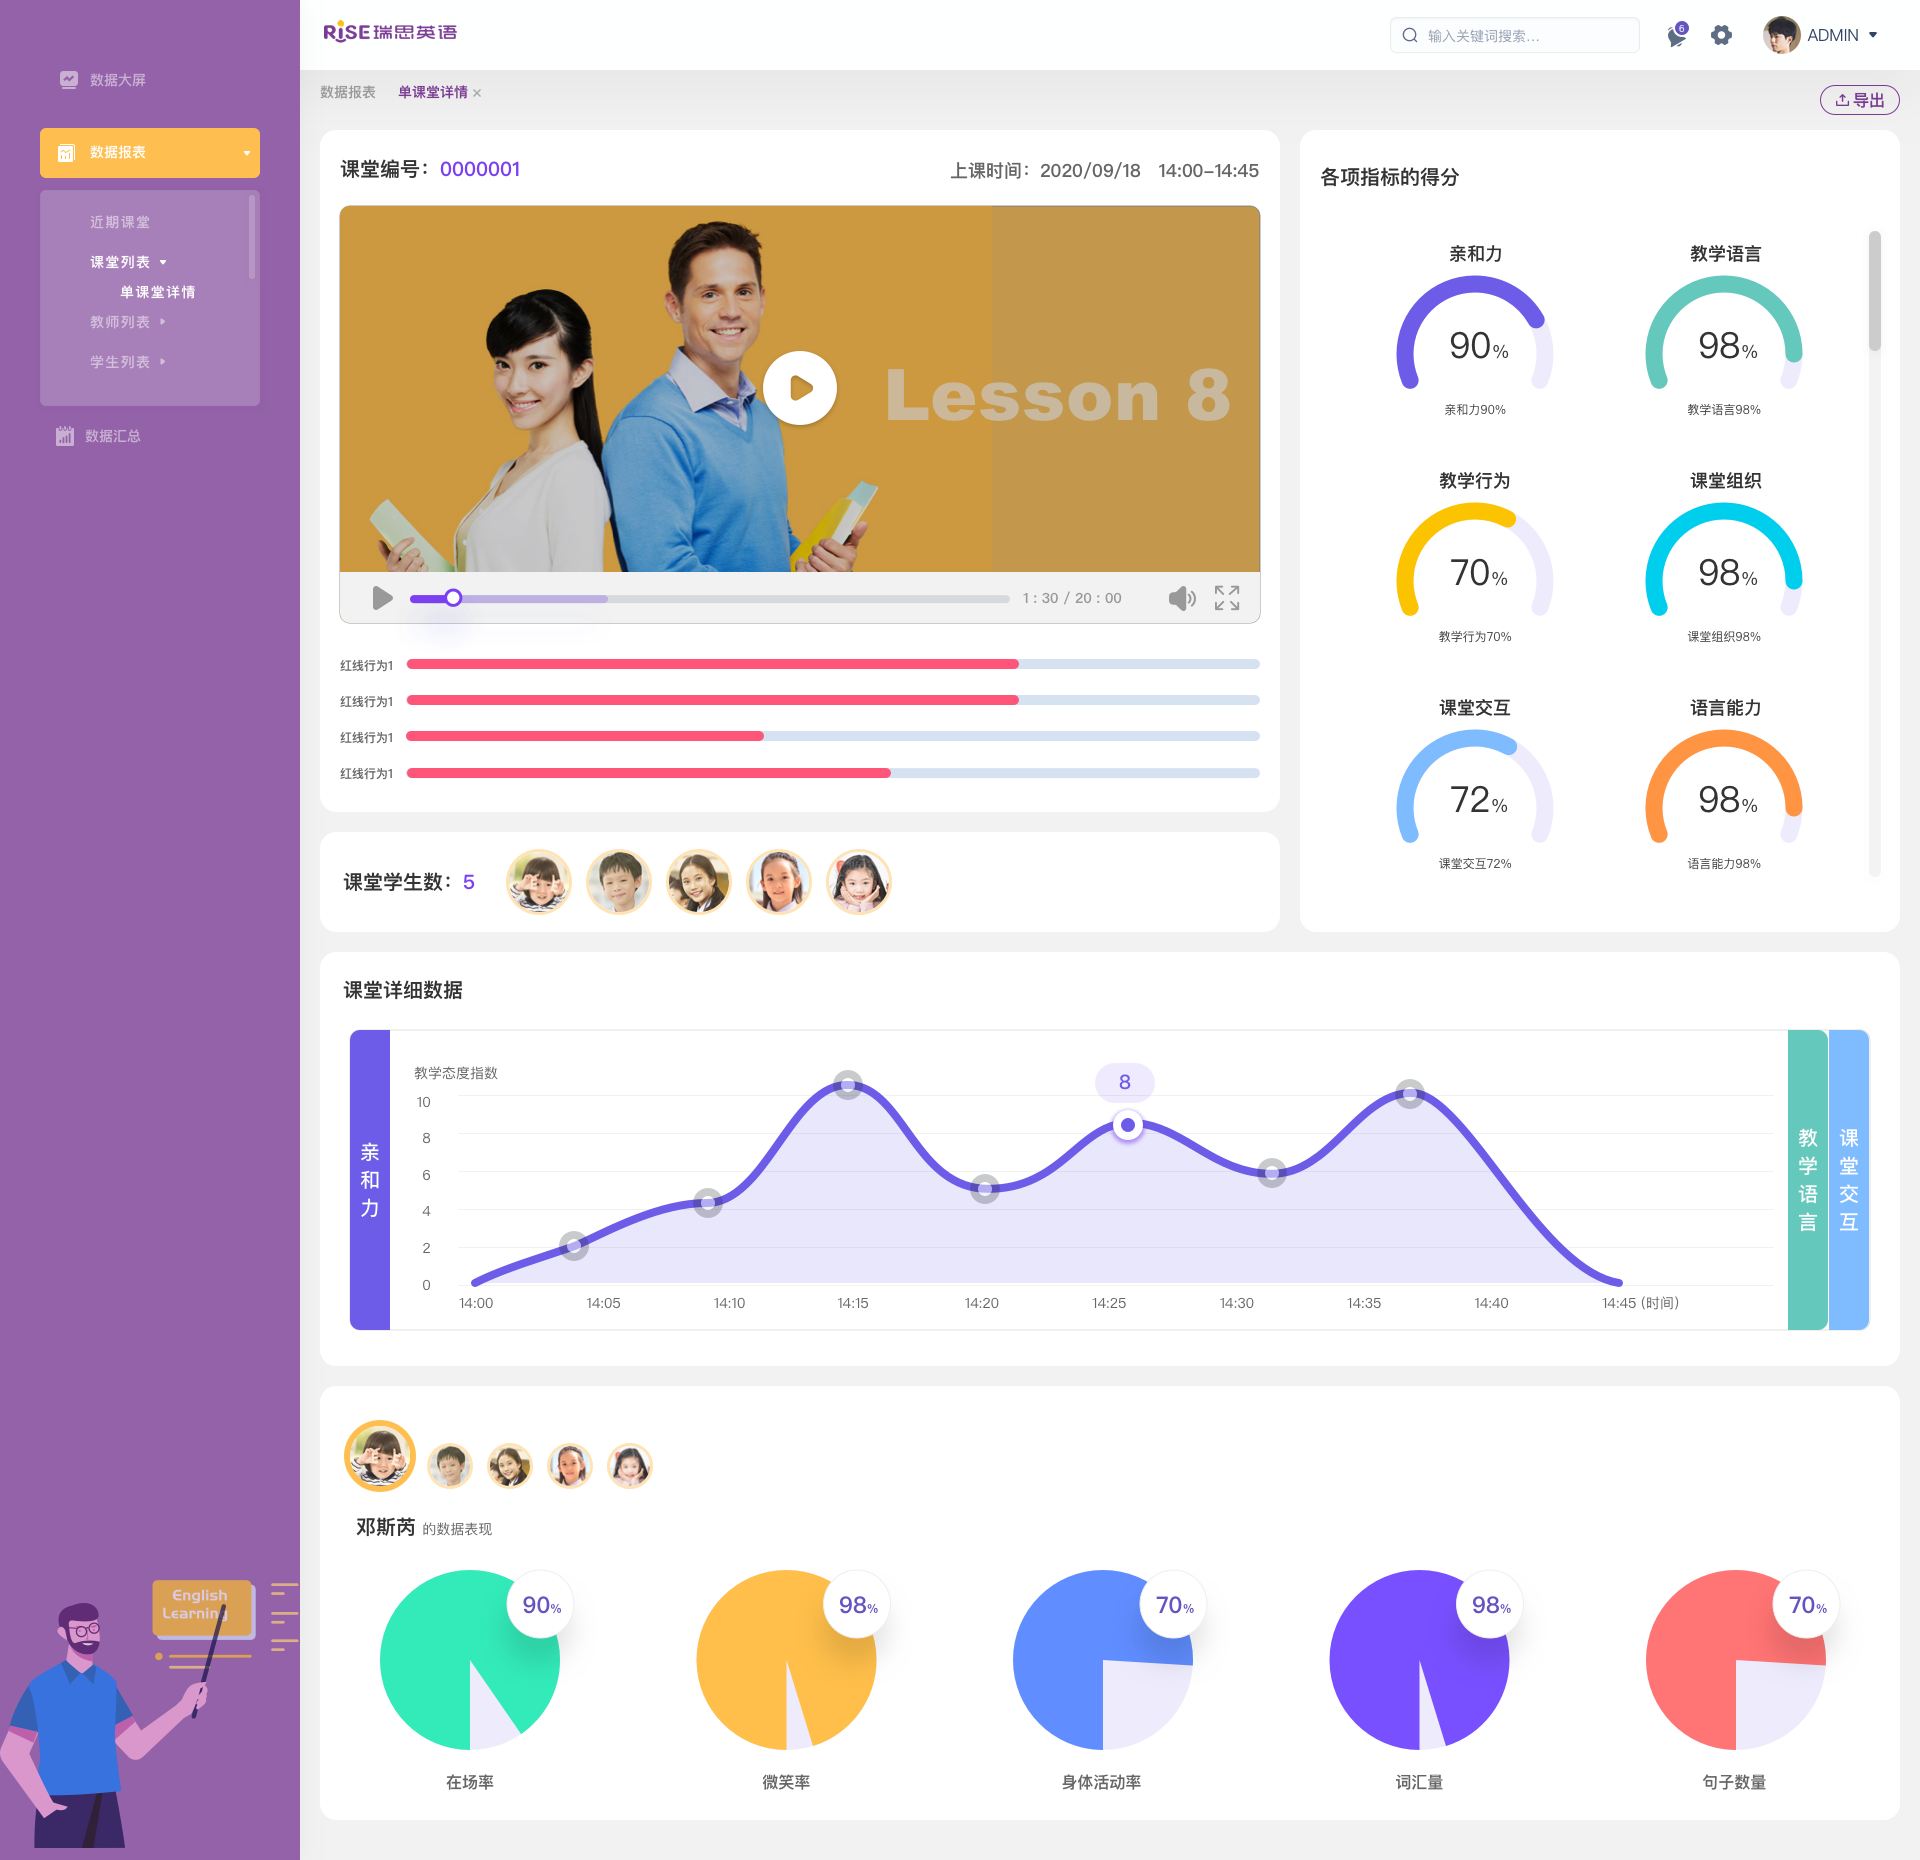
课堂行为分析产品(管理后台)

课堂行为分析产品(管理后台)

面向英语教室:从课堂视频可视化学生专注度与教师各项指标的仪表盘。

  • Vue
  • ECharts
  • Tornado
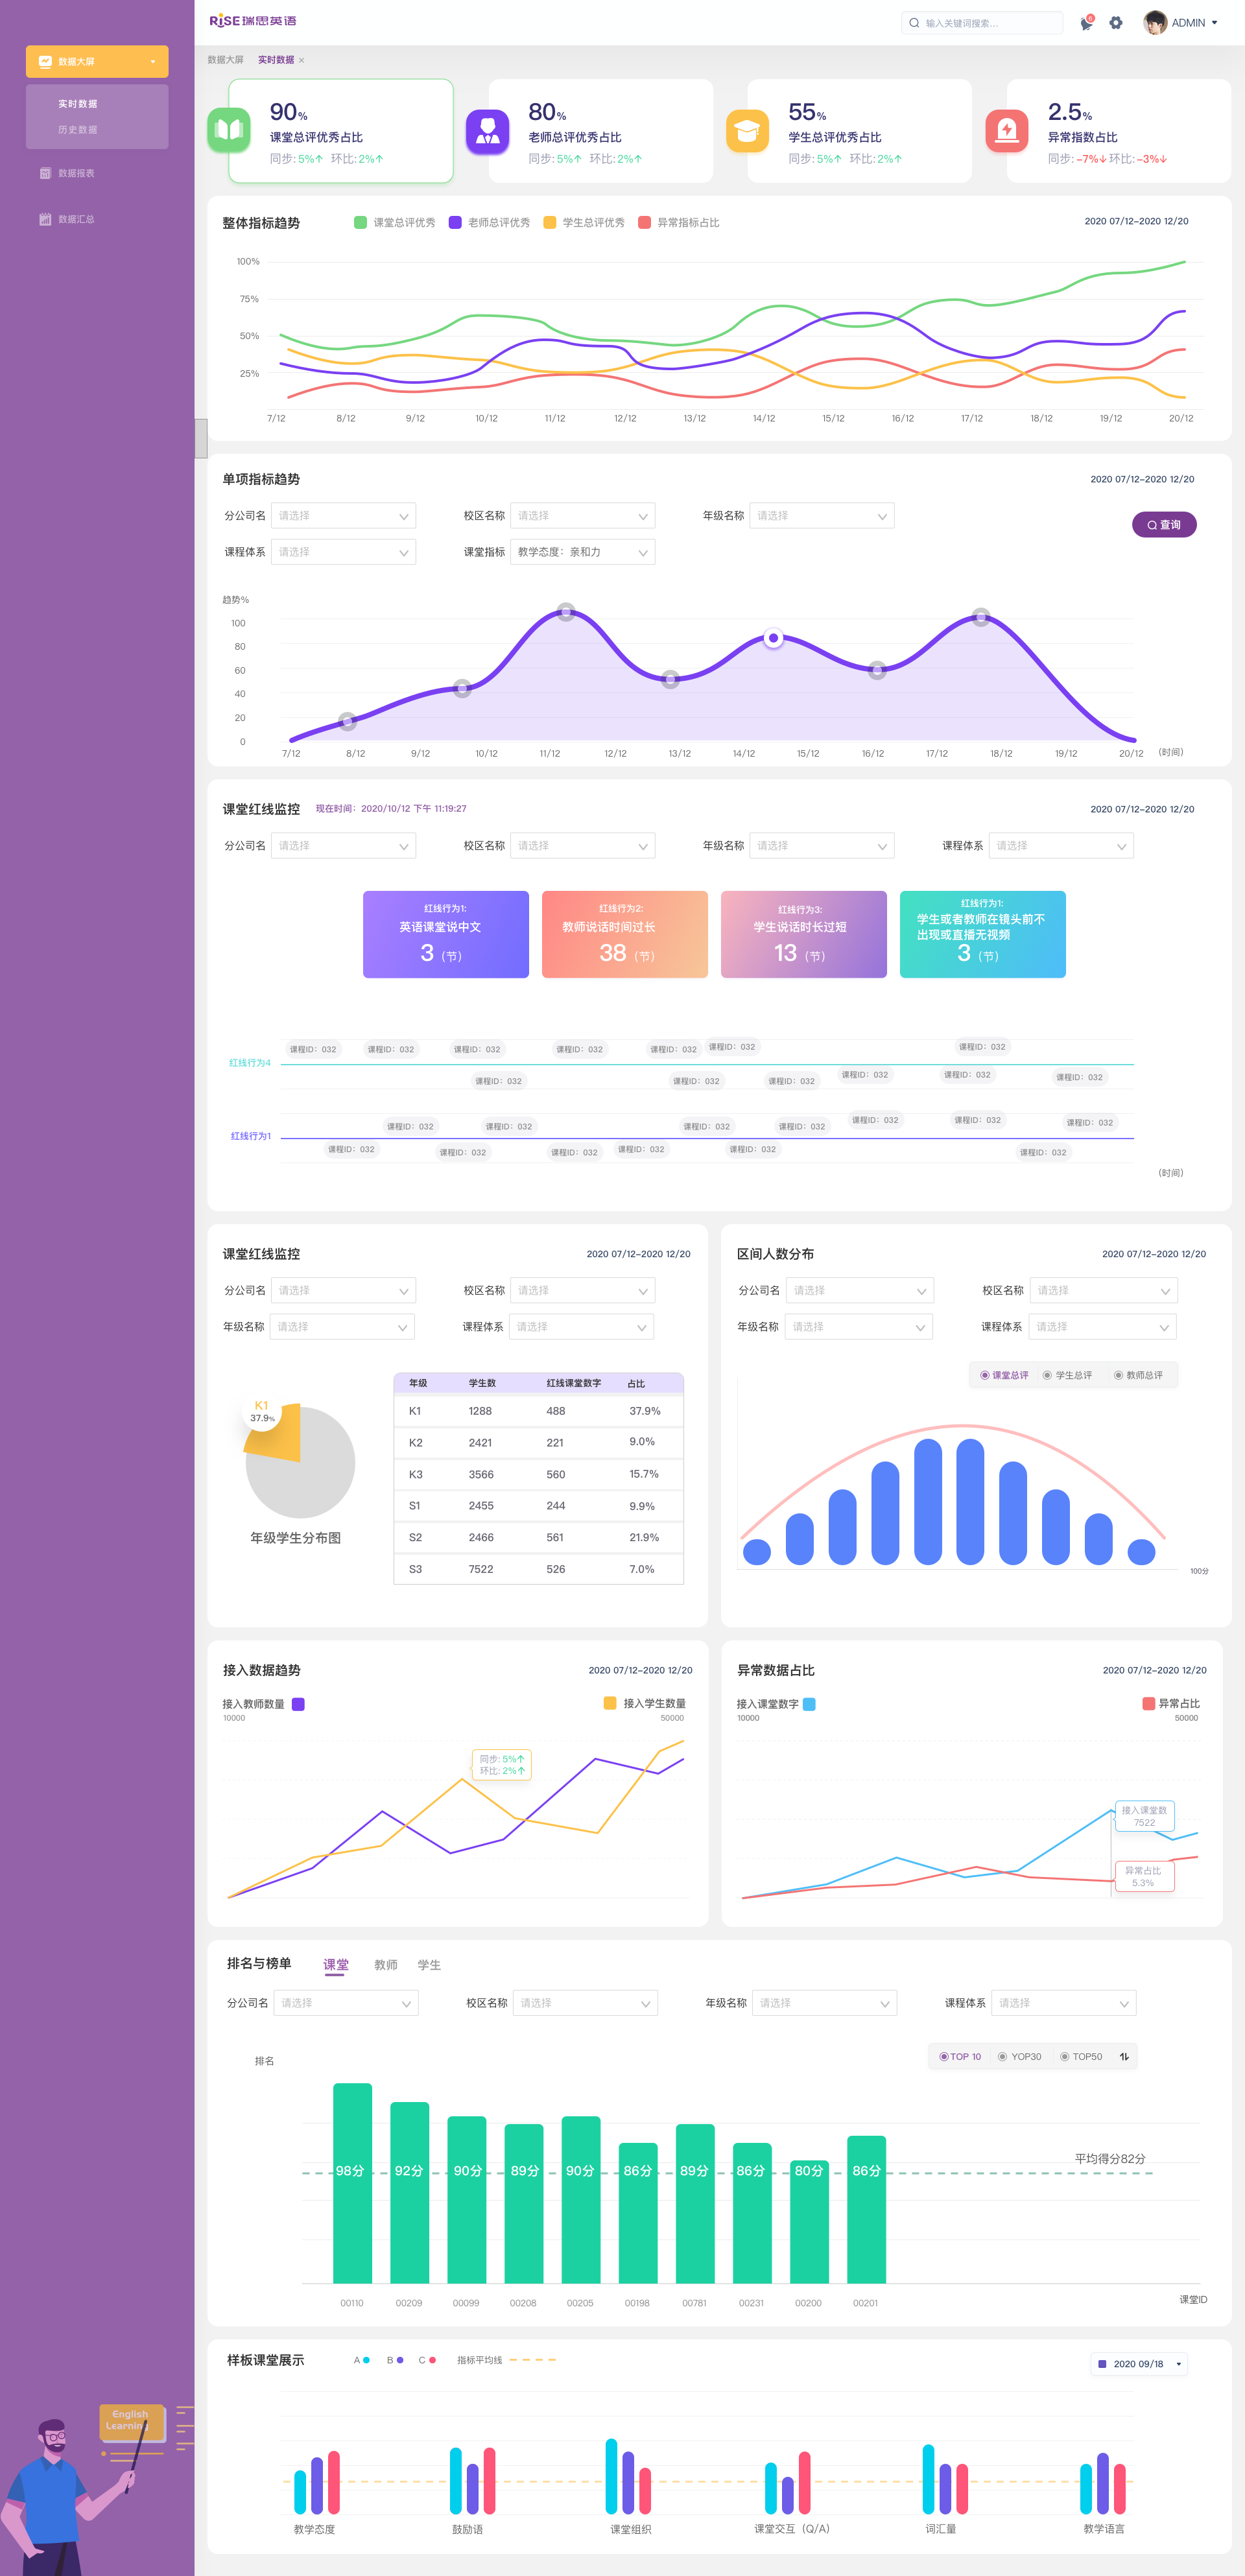
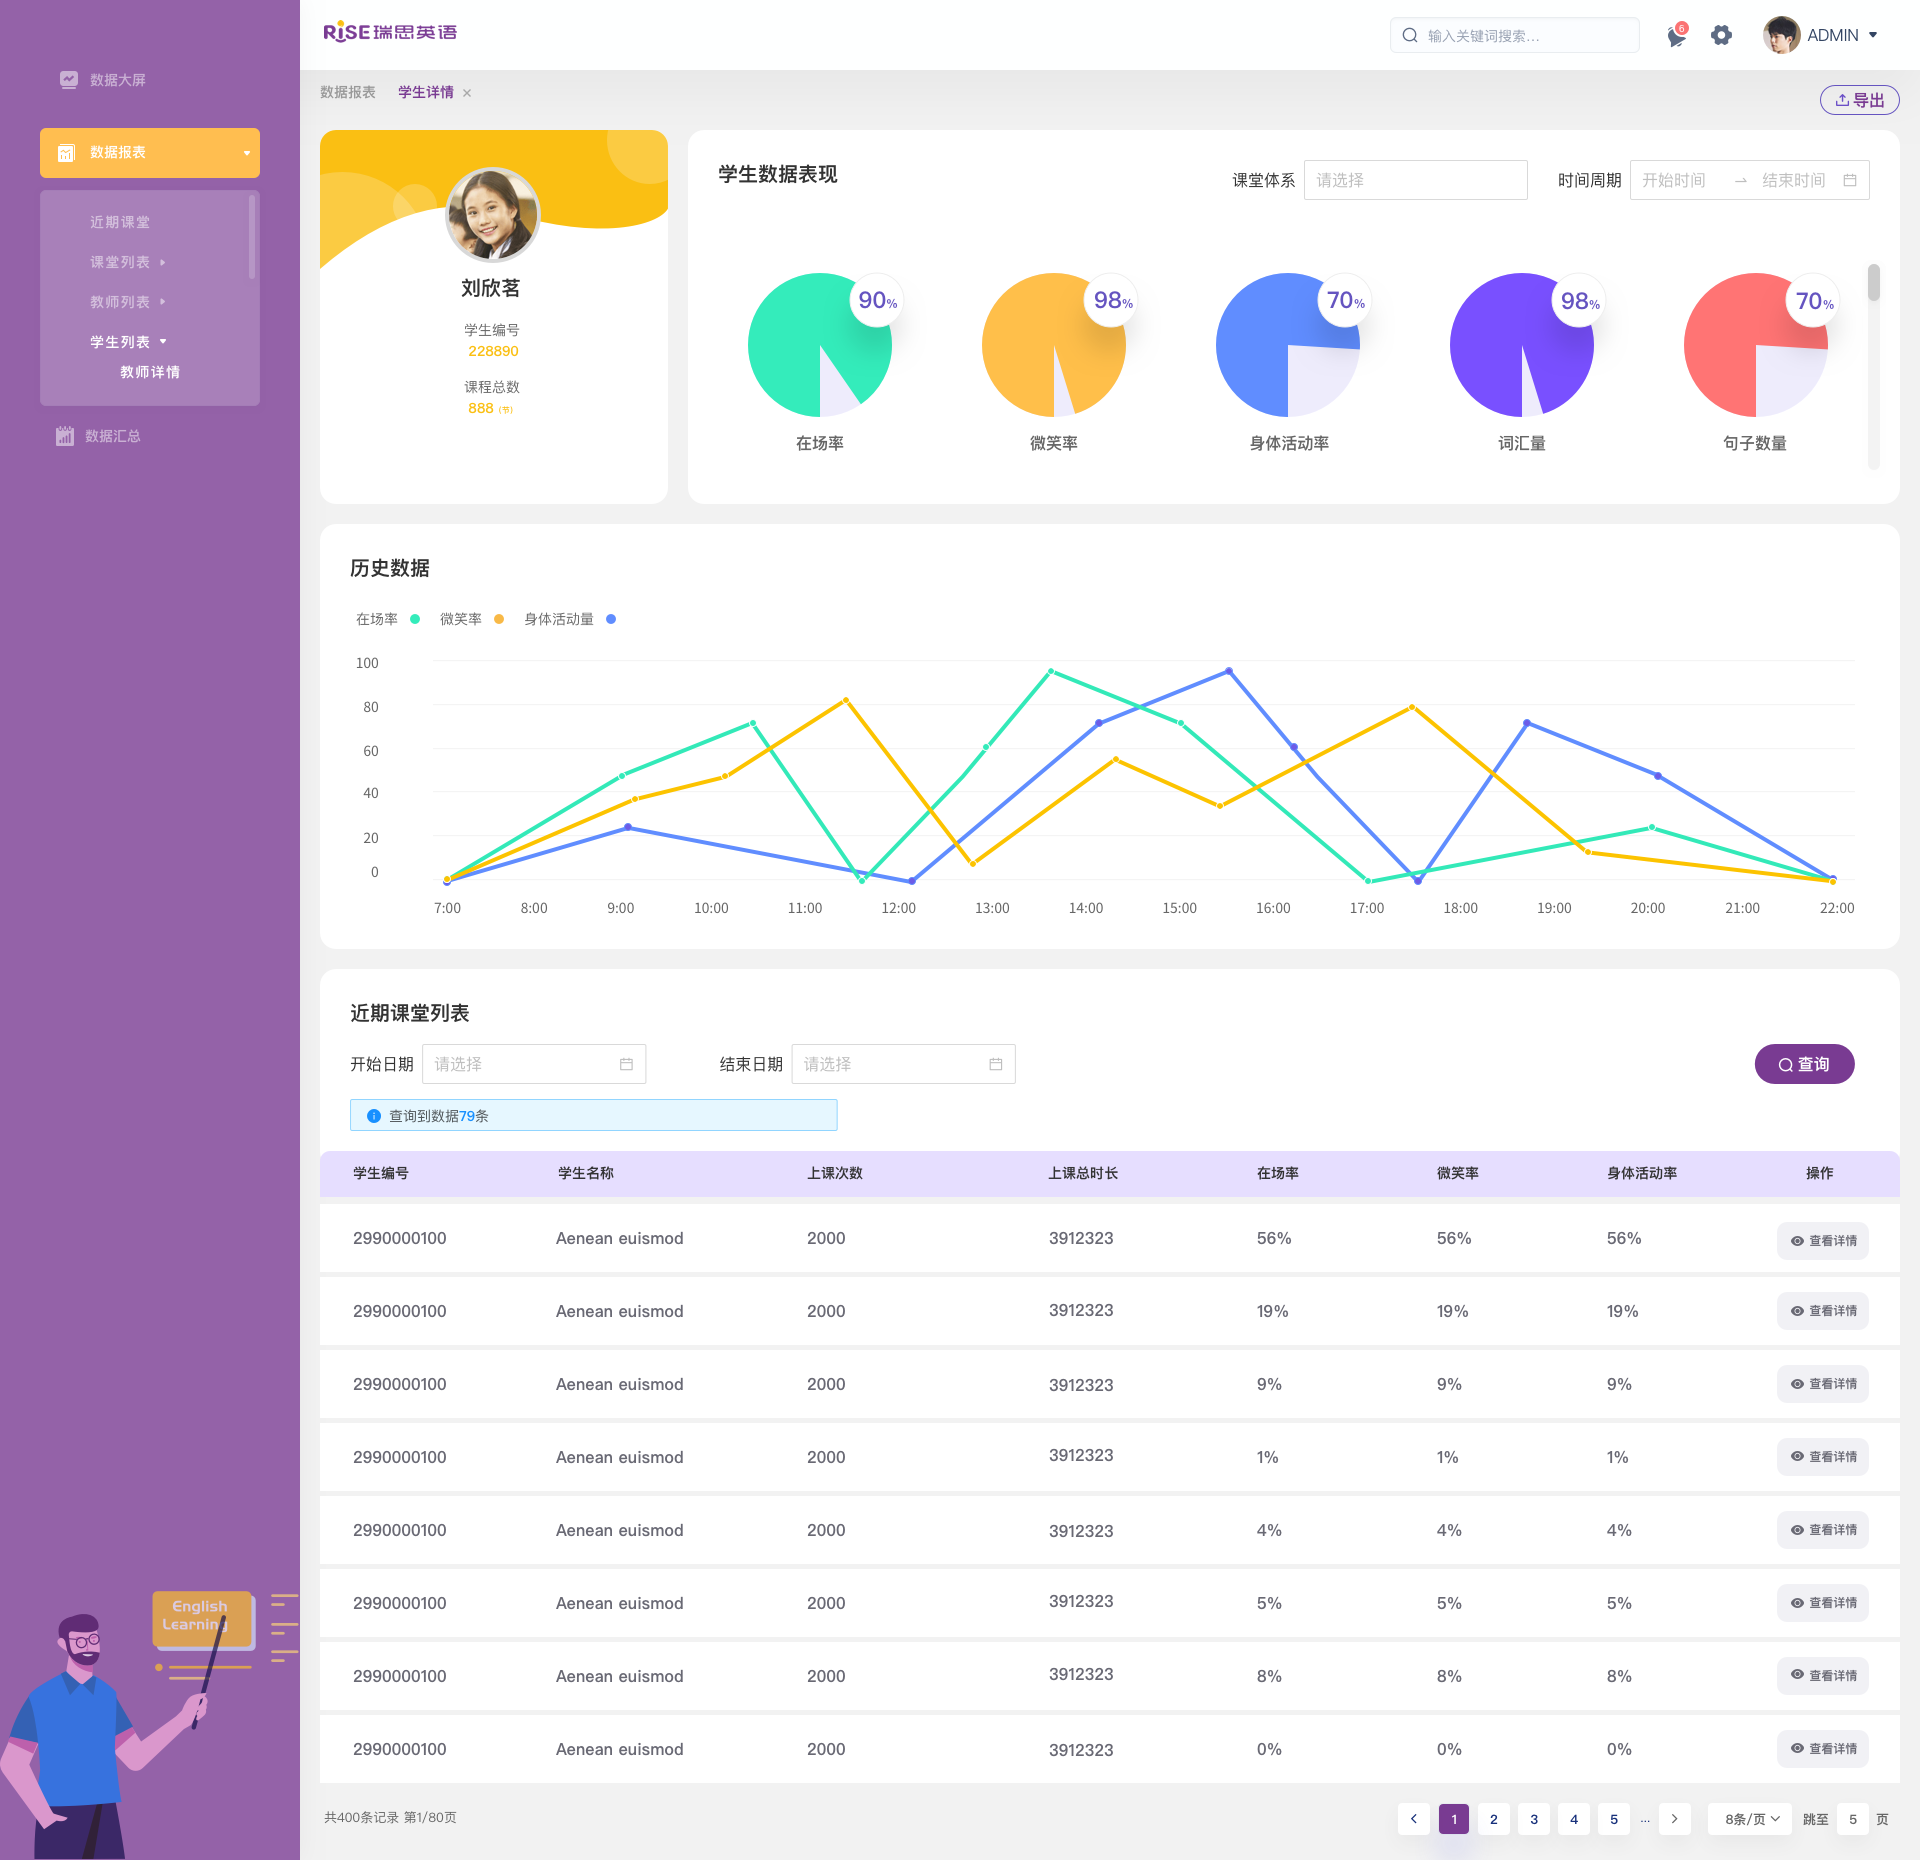
数据大屏

数据大屏

汇总教室、教师、学生各项指标的大屏视图。

  • Vue
  • ECharts
学生详情报告

学生详情报告

按学生汇总在场率、微笑率、举手等行为指标,生成周报/月报。

  • scikit-learn
  • Tornado
上课行为分类

上课行为分类

对抬头、低头、扭头、趴桌、站立等姿态做图像分类,训练并应用 ResNet。
  • PyTorch
  • ResNet
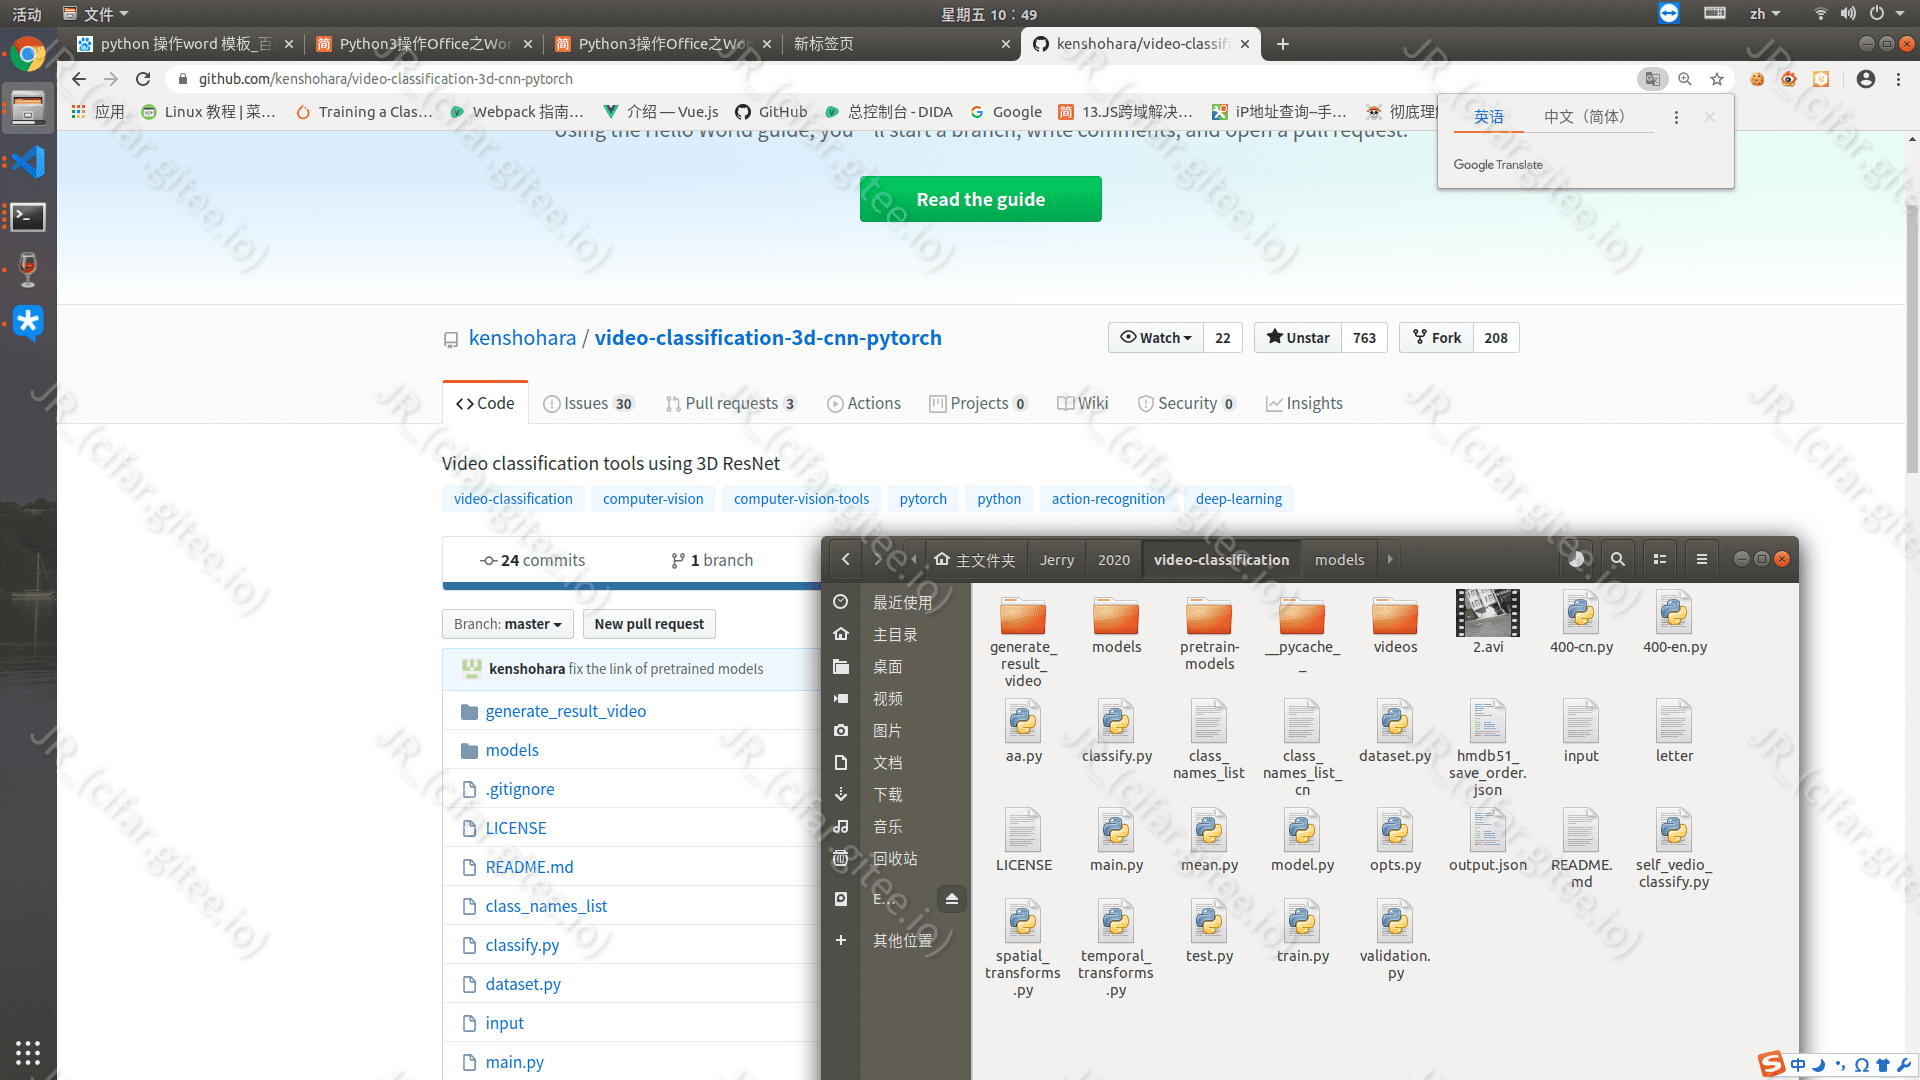
视频动作分类

视频动作分类

使用 3D-ResNet 对含时序的人体动作进行分类。

  • PyTorch
  • 3D-ResNet
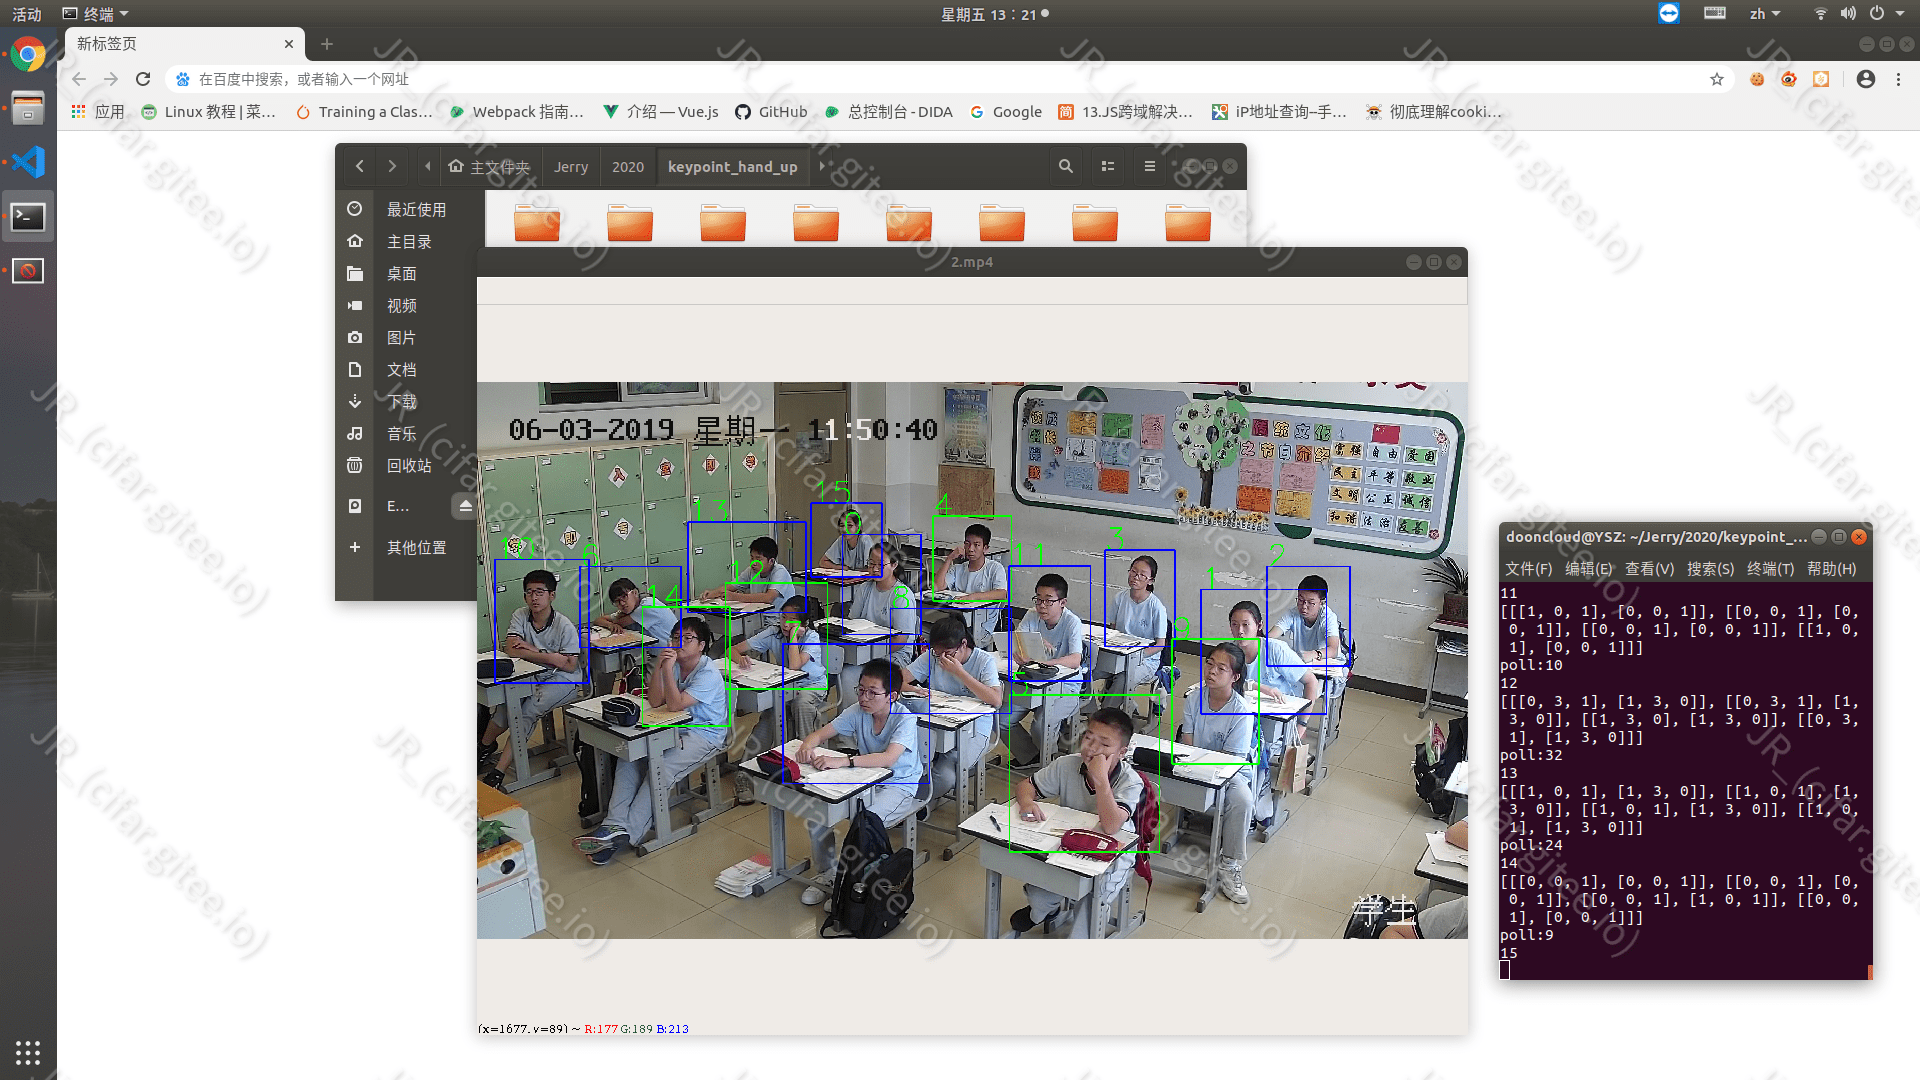
关键点检测(举手 / 仰卧起坐计数)

关键点检测(举手 / 仰卧起坐计数)

用 Detectron2 提取人体关键点,用于举手判定与仰卧起坐计数。

  • Detectron2
  • PyTorch
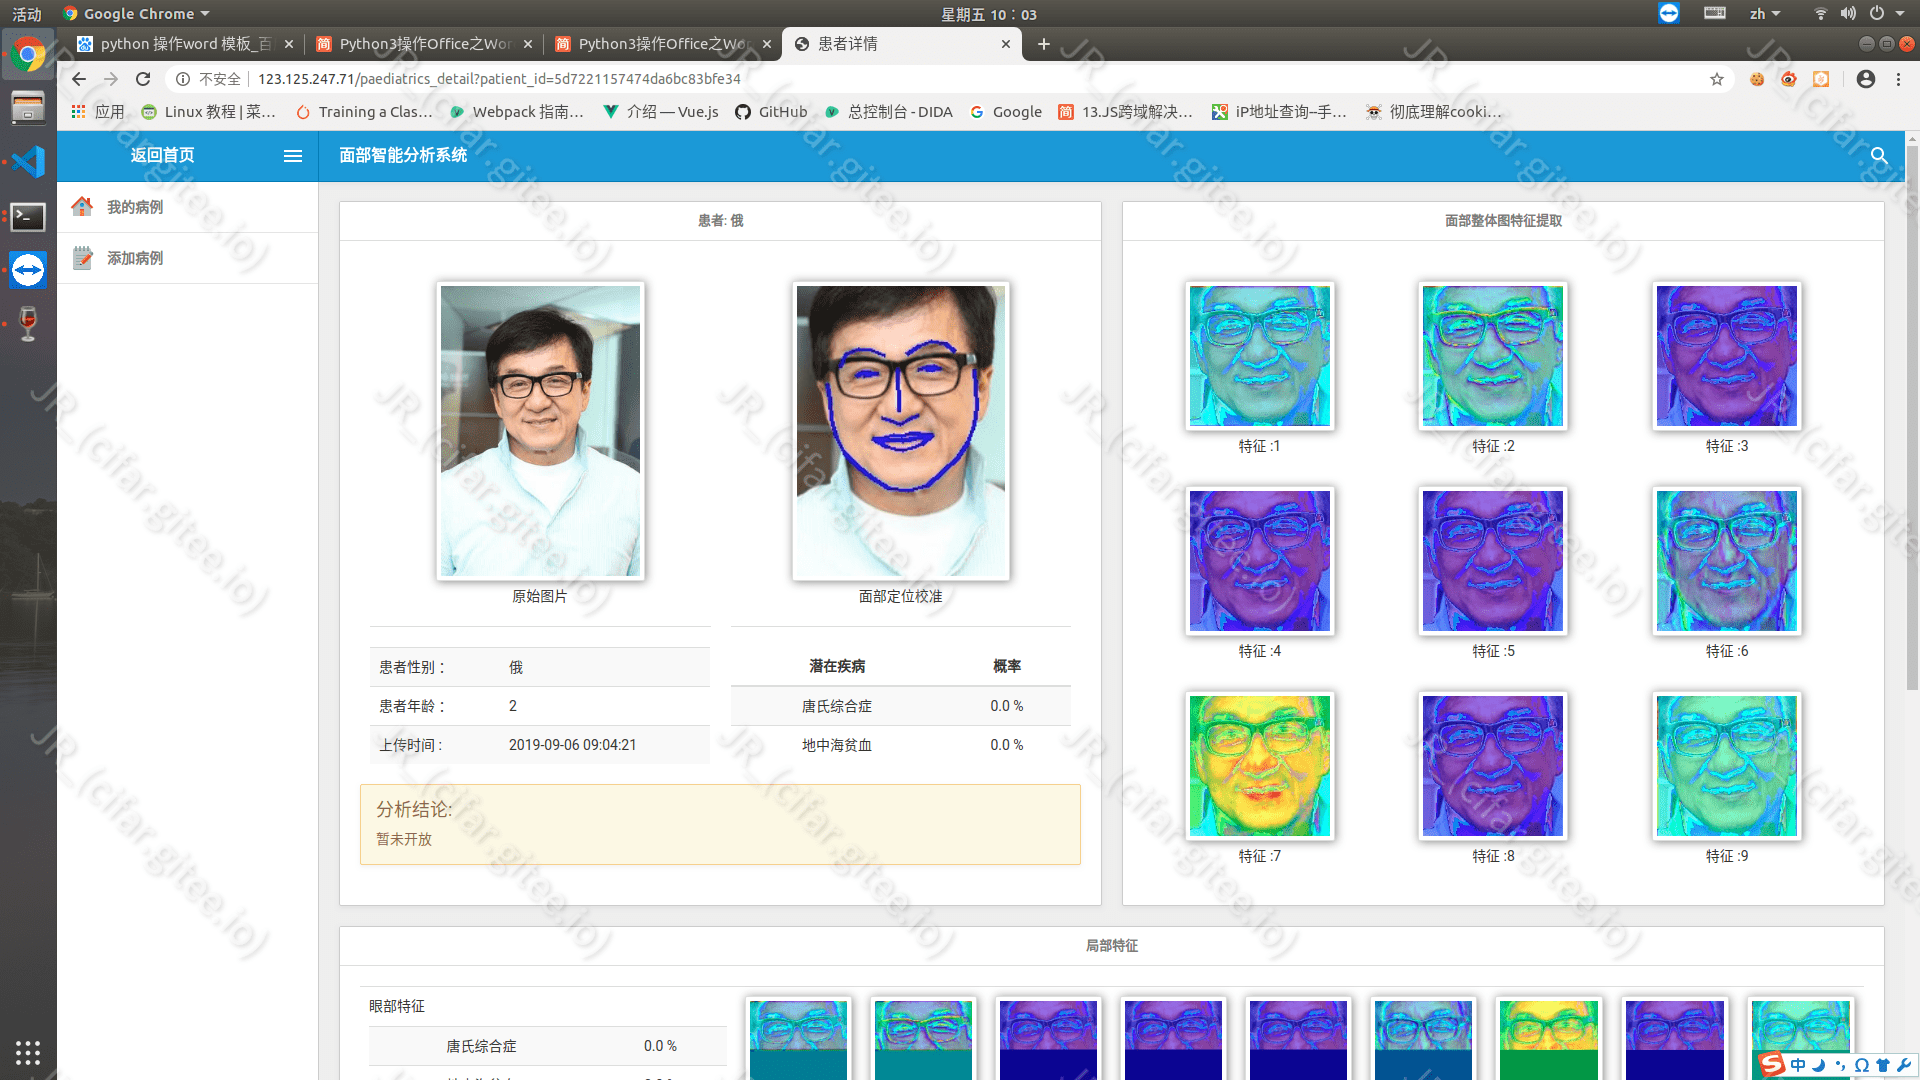
面部智能分析系统

面部智能分析系统

用 Dlib 做人脸关键点检测与特征提取的 MVC Web 系统试作。

  • Dlib
  • Tornado
  • MongoDB

获奖 ↗ 查看证书图片

  • 2018 全国大学生数学建模竞赛 — 河北省二等奖
  • 2018 美国大学生数学建模竞赛(MCM/ICM) — Successful Participant
  • 2018 “正大杯”全国大学生市场调查与分析大赛 — 河北省一等奖
  • 2017 内蒙古数学建模比赛 — 参赛获奖
  • 2016–2019 校奖学金 — 三等(大二至大四),另获勤奋学习奖

毕业后的第一份简历(图片):2019 届本科毕业时的求职简历。

2019 · first-resume.png

打开 2019 年版 ↗

以上只是节选。学习笔记、详细截图与当时的个人页都原样保留在 2020 年版网站里。

2020 · resume-master

打开 2020 年版 ↗

2023 年求职时使用的简历(PDF,中文版):2019–2023 年在中国的工作经历与项目。

2023 · jia_rui_2023.pdf

打开 2023 年版 PDF ↗

2025 年在日本求职时使用的简历(Google 表格,日文版)。

2025 · Google Sheets

打开 2025 年版 ↗

CONTACT

联系我

工作洽谈请通过邮件联系。